El problema
Monté este pipeline para que un despliegue malo se deshaga solo, en minutos y sin nadie mirando la consola. CodePipeline orquesta, CodeDeploy despliega por fases y una alarma de CloudWatch decide si se sigue o se vuelve atrás.
El punto de partida es habitual. Un pipeline que solo hace build y deploy entrega más rápido, pero también rompe más rápido. Le falta lo que pasa después: comprobar que la versión nueva va bien y volver a la anterior cuando no.
El rollback no es un paso de emergencia: es una etapa más del pipeline, con sus condiciones escritas y probadas.
El recorrido completo
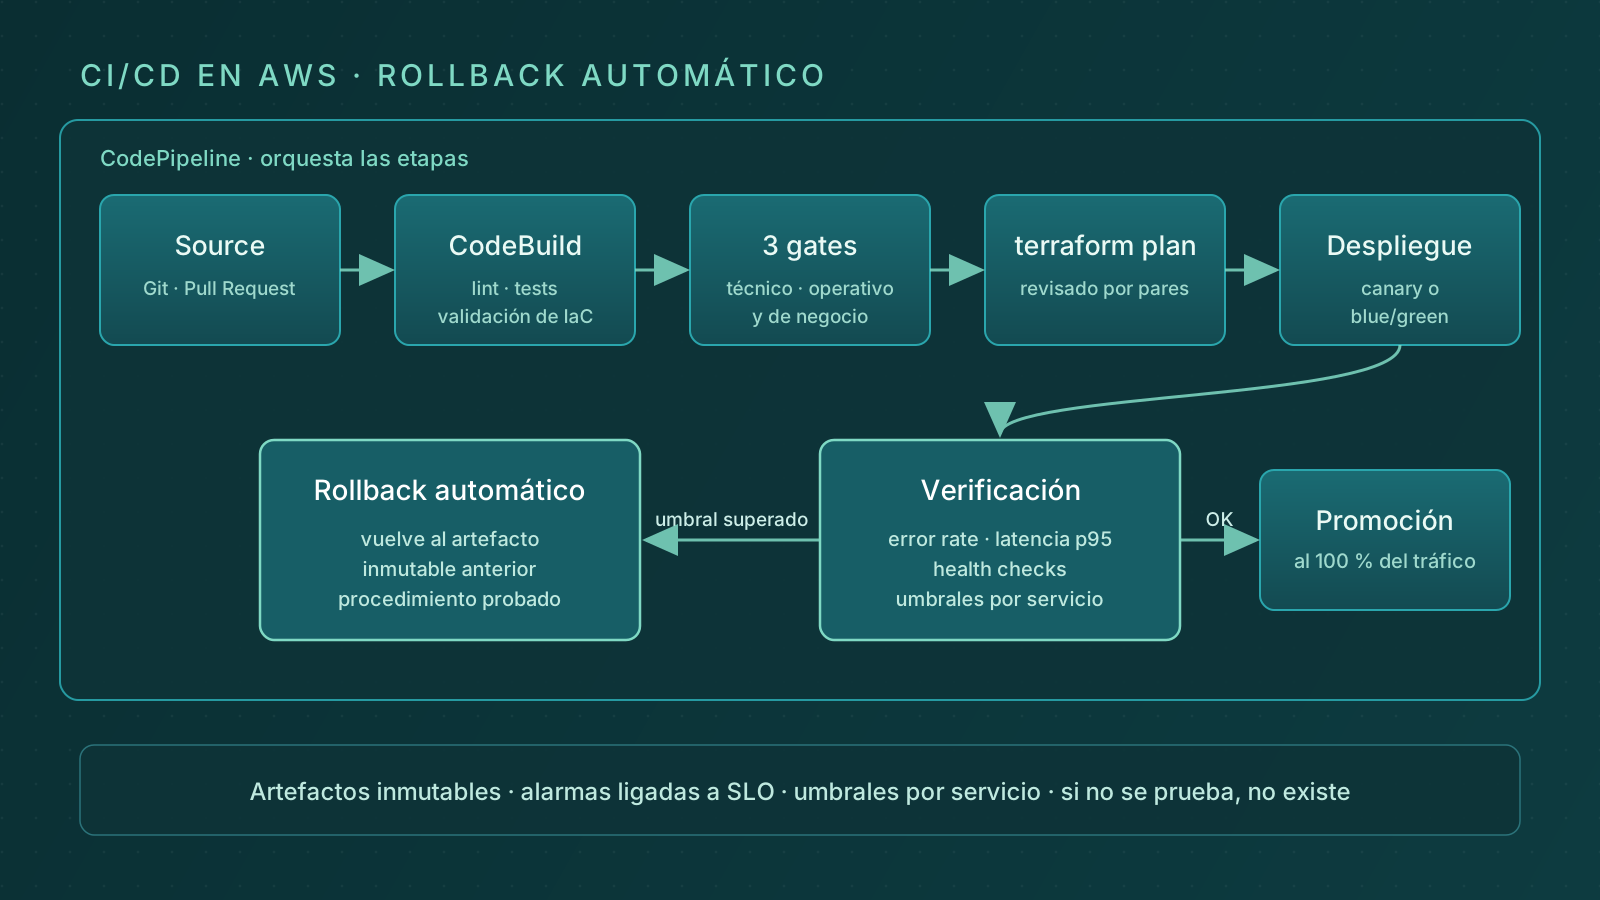
El diagrama de arriba resume el flujo. Cada etapa tiene una sola responsabilidad y cualquiera de ellas puede parar el pipeline.
- Source: un pull request aprobado contra
maindispara CodePipeline. - CodeBuild: lint, tests y
terraform validate; produce una imagen etiquetada con el hash del commit. - Tres gates: técnico, operativo y de negocio.
terraform plan: se guarda como artefacto y lo revisa otra persona antes de aplicar.- Despliegue progresivo: canary o blue/green con CodeDeploy.
- Verificación: error rate, latencia p95 y health checks contra los umbrales del servicio.
- Promoción al 100 % del tráfico, o rollback automático al artefacto anterior.
La imagen se construye una sola vez y viaja intacta por todas las etapas. Si cada entorno recompilara, el rollback volvería a algo que nunca se probó.
Tres gates antes de tocar producción
El gate técnico lo pasa CodeBuild. Tests unitarios y de integración, análisis de dependencias y políticas de IaC: etiquetas obligatorias, cifrado activado y nada público por defecto.
El gate operativo comprueba que el servicio se puede vigilar. Si las alarmas de error rate y latencia no existen, el despliegue progresivo no tiene con qué decidir. El pipeline se para ahí.
El gate de negocio es una aprobación manual de CodePipeline. Fija quién es el responsable de la release, en qué ventana sale y qué significa que haya ido bien.
Una aprobación que se da sin leer es peor que no tenerla, porque da sensación de control. Pide tres datos, no un formulario.
La alarma que decide
Todo el rollback depende de una alarma de CloudWatch. Este ejemplo calcula el error rate y salta si pasa del 2 % durante cinco minutos seguidos. El umbral es de ejemplo: cada servicio necesita el suyo.
# infra/deploy/alarms.tf — ejemplo: error rate > 2 % durante 5 minutos, por target group
resource "aws_cloudwatch_metric_alarm" "demo_api_5xx" {
  for_each = { blue = aws_lb_target_group.demo_blue, green = aws_lb_target_group.demo_green }

  alarm_name          = "demo-api-5xx-${each.key}"
  comparison_operator = "GreaterThanThreshold"
  threshold           = 2
  evaluation_periods  = 5
  treat_missing_data  = "notBreaching"

  metric_query {
    id          = "error_rate"
    expression  = "100 * errors / requests"
    return_data = true
  }

  metric_query {
    id = "errors"
    metric {
      namespace   = "AWS/ApplicationELB"
      metric_name = "HTTPCode_Target_5XX_Count"
      stat        = "Sum"
      period      = 60
      dimensions  = { LoadBalancer = aws_lb.demo.arn_suffix, TargetGroup = each.value.arn_suffix }
    }
  }

  metric_query {
    id = "requests"
    metric {
      namespace   = "AWS/ApplicationELB"
      metric_name = "RequestCount"
      stat        = "Sum"
      period      = 60
      dimensions  = { LoadBalancer = aws_lb.demo.arn_suffix, TargetGroup = each.value.arn_suffix }
    }
  }
}
La alarma de latencia sigue la misma forma, con TargetResponseTime y extended_statistic = "p95". Los health checks se vigilan con UnHealthyHostCount mayor que cero.
El for_each no es decorativo. En blue/green, CodeDeploy alterna los dos target groups en cada despliegue, así que hay una alarma por cada uno. La que mide al grupo sin tráfico no tiene datos y no salta.
Una alarma sobre el balanceador entero no ve un canary del 10 %. Un 20 % de errores en el canary queda en un 2 % global.
Quién ejecuta el rollback
La alarma decide y CodeDeploy ejecuta. El grupo de despliegue lleva la lista de alarmas y la orden de volver atrás si alguna entra en ALARM.
# infra/deploy/codedeploy.tf — la alarma decide y CodeDeploy ejecuta
resource "aws_codedeploy_deployment_group" "demo_api" {
  app_name               = aws_codedeploy_app.demo.name
  deployment_group_name  = "demo-api"
  service_role_arn       = "arn:aws:iam::123456789012:role/demo-codedeploy"
  deployment_config_name = "CodeDeployDefault.ECSCanary10Percent15Minutes"

  alarm_configuration {
    enabled = true
    # aquí van también las de latencia p95 y health checks, definidas igual
    alarms  = [for a in values(aws_cloudwatch_metric_alarm.demo_api_5xx) : a.alarm_name]
  }

  auto_rollback_configuration {
    enabled = true
    events  = ["DEPLOYMENT_FAILURE", "DEPLOYMENT_STOP_ON_ALARM"]
  }

  # ecs_service, load_balancer_info y blue_green_deployment_config, aparte
}
El canary manda el 10 % del tráfico a la versión nueva durante 15 minutos. Si ninguna alarma salta, CodeDeploy pasa el resto. Si salta una, devuelve el tráfico a la versión anterior.
Elegí 15 minutos y no 5 a propósito. La alarma necesita cinco minutos de datos para disparar: la ventana del canary tiene que ser más larga que la evaluación de la alarma. Si no, la promoción llega antes que el aviso.
Con blue/green conservo además las tareas antiguas un rato después de promocionar. Mientras existan, volver atrás es mover el tráfico del listener, no desplegar de nuevo.
Lo que el rollback no deshace
CodeDeploy devuelve el tráfico a la imagen anterior, pero no toca la base de datos. Si la versión nueva borró o renombró una columna, la antigua vuelve y falla igual.
Por eso las migraciones van en dos tiempos: primero se añade lo nuevo sin quitar nada; lo viejo se elimina en una release posterior. Así cualquier versión puede convivir con el esquema del momento.
Con la infraestructura pasa algo parecido. Lo que aplica terraform apply no lo revierte CodeDeploy. Por eso el plan se revisa antes, y deshacerlo es otro cambio que pasa por el mismo pipeline.
Un rollback automático solo es seguro si la versión anterior puede funcionar con el estado que dejó la nueva.
Probarlo antes de necesitarlo
Un rollback que nunca se ha ejecutado es una hipótesis. Lo pruebo en un entorno previo con una versión que devuelve errores a propósito, activada por una variable de entorno.
El pipeline debe pararse solo, devolver el tráfico y avisar. Si no lo hace, el fallo está en la alarma o en sus umbrales, y es mejor descubrirlo ahí que en producción.
Las alarmas también se escriben como código. Explico ese enfoque en Alertas preventivas en AWS como código con Terraform. Y si quieres ver qué cuesta cada cambio, añade la capa de Observabilidad FinOps en AWS: detectar desvíos a tiempo.
- Una imagen por commit, la misma en todos los entornos.
terraform planrevisado por otra persona antes de aplicar.- Alarmas de error rate y latencia por target group, con umbrales del servicio.
- Ventana del canary más larga que la evaluación de la alarma.
- Migraciones compatibles con la versión anterior.
- Rollback provocado y comprobado en un entorno previo.
Lo que aprendí
Una alarma sobre todo el tráfico no ve un canary pequeño: sus errores se diluyen en la parte sana. Medir por target group fue lo que hizo que el rollback saltara cuando debía.
Si tienes dudas o lo estás montando tú, cuéntamelo.