El problema
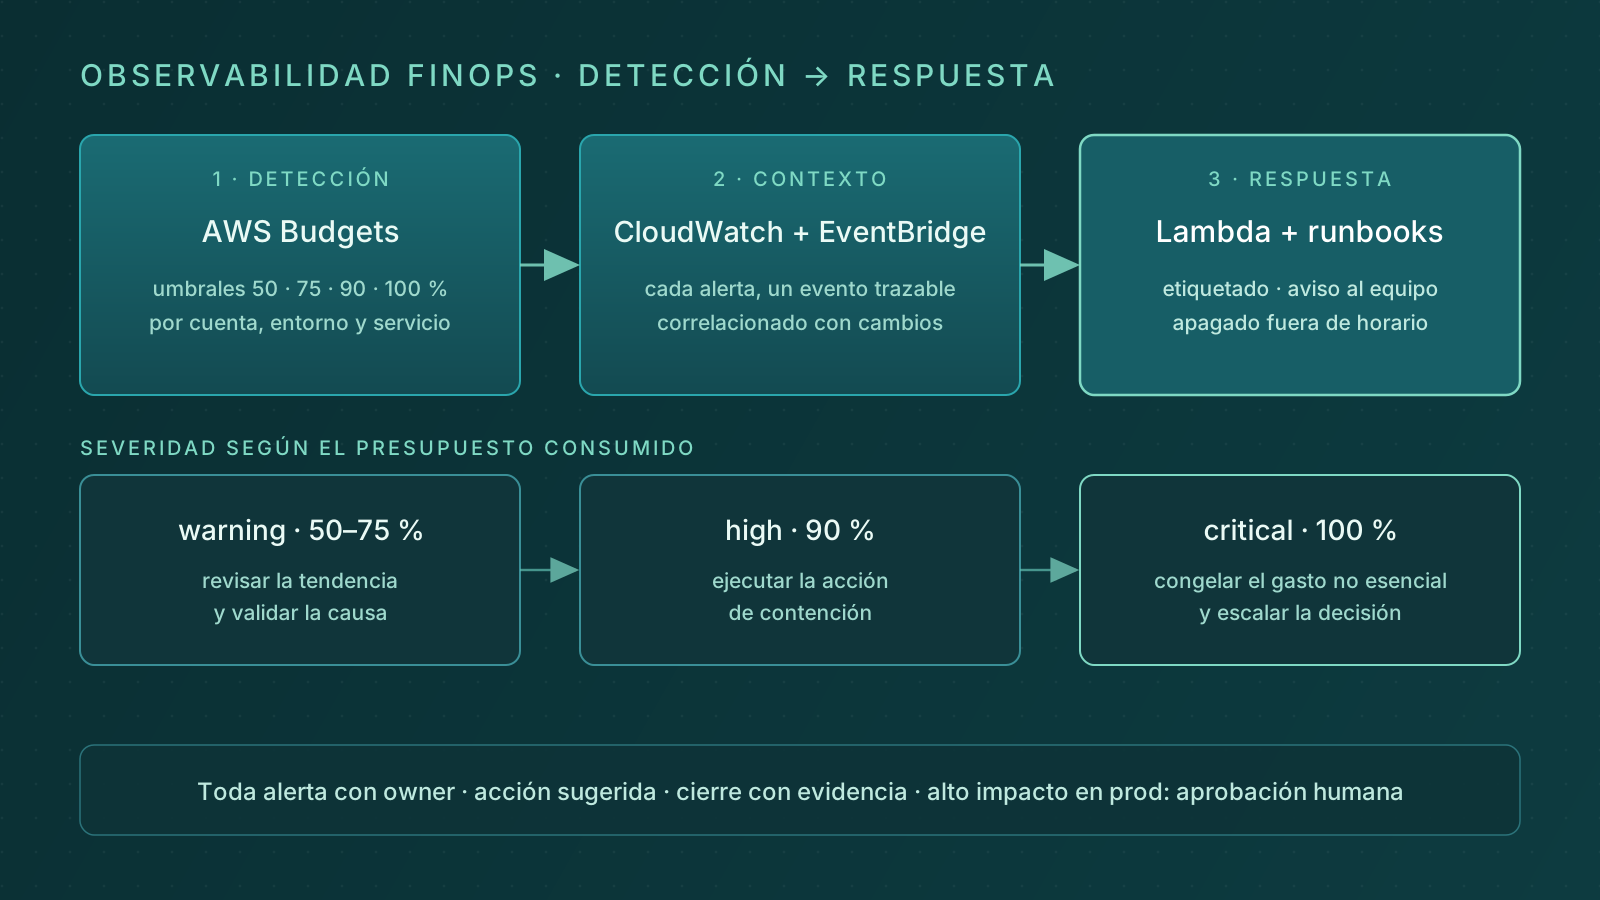
Monté una cadena que avisa de un desvío de coste cuando empieza, no a fin de mes. Budgets lo detecta, EventBridge lo reparte con contexto y Lambda ejecuta las respuestas de bajo riesgo.
Mirar la factura a fin de mes es hacer la autopsia. Para entonces el desvío lleva semanas y el recorte llega con prisas y sin matices.
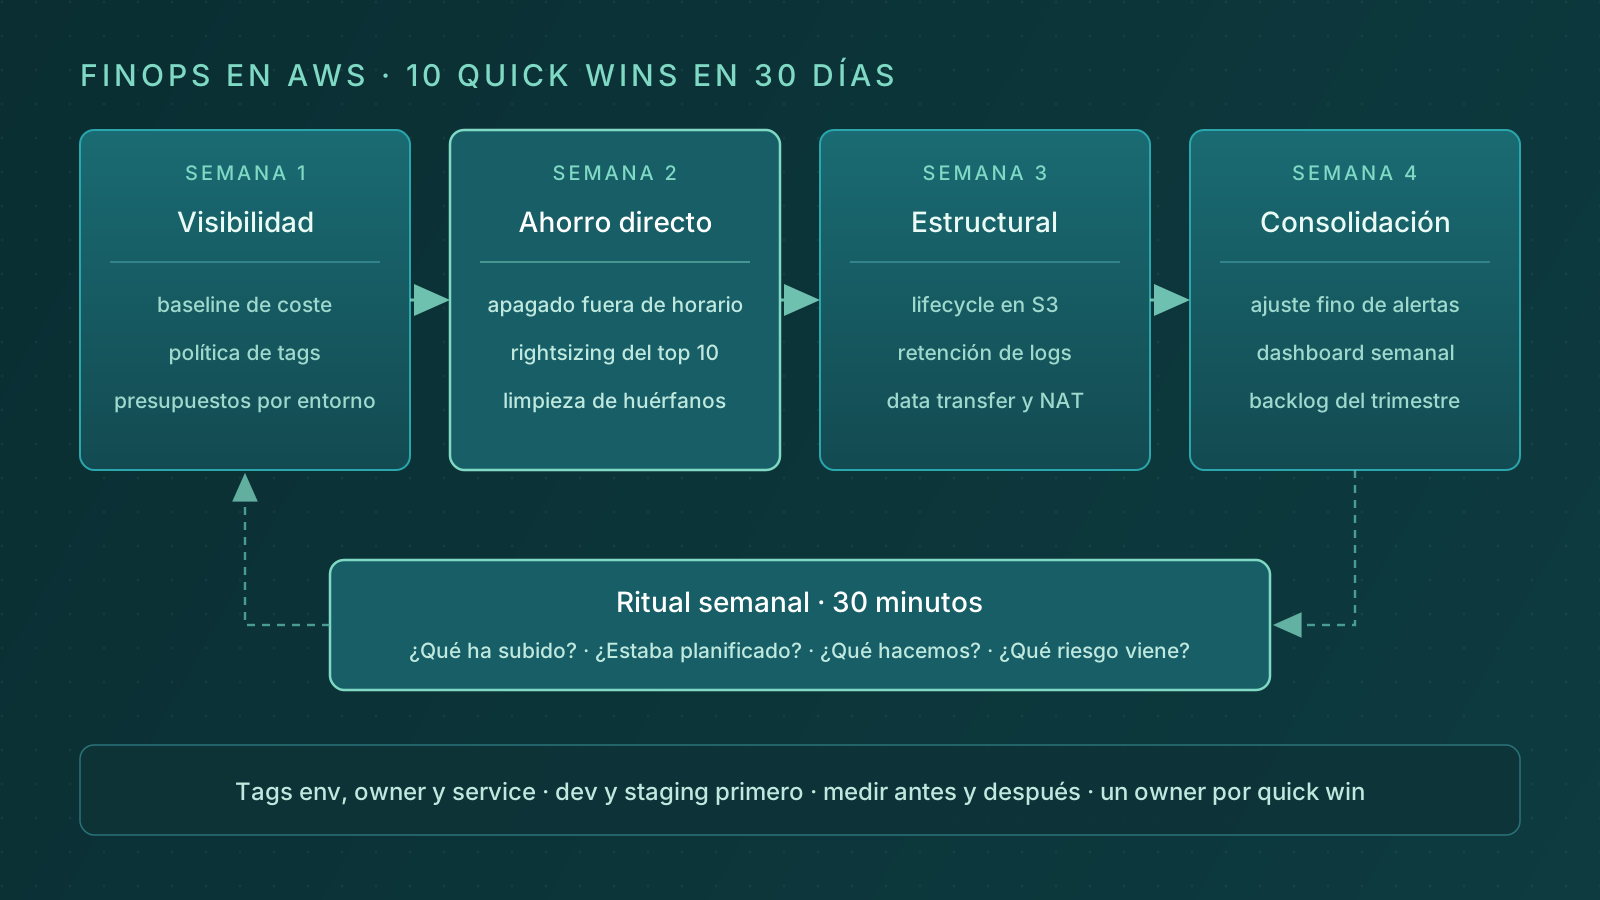
Este post va de vigilar. Qué recortar y en qué orden está en FinOps en AWS: 10 quick wins en 30 días. Aquí parto de que las etiquetas env, owner y service ya existen.
Una alerta sin owner, sin severidad y sin acción sugerida no es una alerta: es ruido.
Tres capas, tres preguntas
- Detección: ¿qué está subiendo? La responde AWS Budgets.
- Contexto: ¿de quién es y por qué sube? La responden CloudWatch y EventBridge.
- Respuesta: ¿qué hacemos hoy? La responden Lambda y los runbooks.
Si falta la tercera, las alertas se acumulan y el equipo deja de leerlas.
Detección: un presupuesto, cuatro umbrales
Cada entorno tiene un presupuesto mensual filtrado por su etiqueta env. Avisa al 50, al 75, al 90 y al 100 %, y cada umbral tiene una severidad:
| Severidad | Presupuesto consumido | Qué se hace |
|---|---|---|
| warning | 50–75 % | Revisar la tendencia y validar la causa |
| high | 90 % | Ejecutar la acción de contención |
| critical | 100 % | Congelar el gasto no esencial y escalar la decisión |
El aviso de Budgets por SNS es un texto pensado para personas. Para no extraer la severidad de ese texto, cada umbral publica en el topic de su severidad:
# finops/budgets.tf — presupuesto de dev: cada umbral va al topic de su severidad
locals {
  severidad = { 50 = "warning", 75 = "warning", 90 = "high", 100 = "critical" }
}

resource "aws_sns_topic" "demo_finops" {
  for_each = toset(["warning", "high", "critical"])
  name     = "demo-finops-${each.key}"
}

# sin esta política, Budgets no puede publicar en el topic
resource "aws_sns_topic_policy" "demo_finops" {
  for_each = aws_sns_topic.demo_finops
  arn      = each.value.arn
  policy = jsonencode({
    Version = "2012-10-17"
    Statement = [{
      Effect    = "Allow"
      Principal = { Service = "budgets.amazonaws.com" }
      Action    = "SNS:Publish"
      Resource  = each.value.arn
      Condition = { StringEquals = { "aws:SourceAccount" = "123456789012" } }
    }]
  })
}

resource "aws_budgets_budget" "demo_dev_monthly" {
  name         = "demo-dev-monthly"
  budget_type  = "COST"
  limit_amount = "500" # importe de ejemplo
  limit_unit   = "USD"
  time_unit    = "MONTHLY"

  cost_filter {
    name   = "TagKeyValue"
    values = ["user:env$dev"]
  }

  dynamic "notification" {
    for_each = local.severidad
    content {
      comparison_operator       = "GREATER_THAN"
      threshold                 = notification.key
      threshold_type            = "PERCENTAGE"
      notification_type         = "ACTUAL"
      subscriber_sns_topic_arns = [aws_sns_topic.demo_finops[notification.value].arn]
    }
  }
}
Con notification_type = "FORECASTED" se puede añadir un quinto aviso: salta cuando la previsión del mes pasa del presupuesto, antes de gastarlo.
Budgets no es tiempo real: los datos de coste se actualizan unas pocas veces al día. Para picos de horas sirve mejor Cost Anomaly Detection.
Contexto: cada alerta, un evento
Una Lambda pequeña está suscrita a los tres topics. Convierte cada aviso en un evento de EventBridge con el entorno, el servicio, el owner y la severidad. El owner sale de las etiquetas.
Desde ahí, cada severidad tiene su regla:
# finops/events.tf — las alertas high y critical disparan el runbook de contención
resource "aws_cloudwatch_event_rule" "demo_finops_contencion" {
  name = "demo-finops-high-critical"
  event_pattern = jsonencode({
    source        = ["demo.finops"]
    "detail-type" = ["Budget Threshold Crossed"]
    detail        = { severity = ["high", "critical"] }
  })
}
# el target (la Lambda de respuesta) se declara aparte con aws_cloudwatch_event_target
El source y el detail-type los pone la Lambda que traduce el aviso. No son eventos nativos de AWS.
En CloudWatch quedan los logs de esa Lambda y un panel con las alertas abiertas por servicio. Con la hora de cada evento cruzo el desvío con los despliegues del mismo servicio. Así llego al cambio que lo provocó, no solo al importe.
Respuesta: automatizo solo lo reversible
La Lambda de respuesta hace tres cosas, y ninguna borra nada:
- Etiqueta los recursos que llegan sin
owner, para que alguien los reclame. - Manda al canal del equipo un aviso con el servicio, la severidad y la acción sugerida.
- Apaga fuera de horario los recursos no productivos que se han quedado encendidos.
Lo que afecta a producción va a un runbook de Systems Manager Automation con un paso aws:approve. La automatización prepara la acción y una persona la confirma.
Si una acción no se deshace en un minuto, no la automatizo. Un apagado erróneo en producción cuesta más que el desvío que quería evitar.
Cerrar el bucle
Una alerta se cierra con evidencia: qué la disparó, qué se hizo y qué control evita que se repita. Las que siguen abiertas al final de la semana van al ritual semanal de FinOps en AWS: 10 quick wins en 30 días.
Para saber si la cadena funciona miro cuatro cosas:
- Tiempo entre el desvío y la primera alerta.
- Tiempo entre la alerta y la acción.
- Porcentaje de alertas con owner.
- Desvíos del mismo tipo que se repiten.
Las etiquetas obligatorias se comprueban antes, en el gate técnico de Pipeline CI/CD en AWS con rollback automático. Un recurso sin owner no llega a desplegarse.
Lo que aprendí
Mandar cada umbral a su propio topic me ahorró interpretar el texto del aviso de Budgets. La severidad la decide la infraestructura, no una expresión regular.
Si tienes dudas o lo estás montando tú, cuéntamelo.