El problema
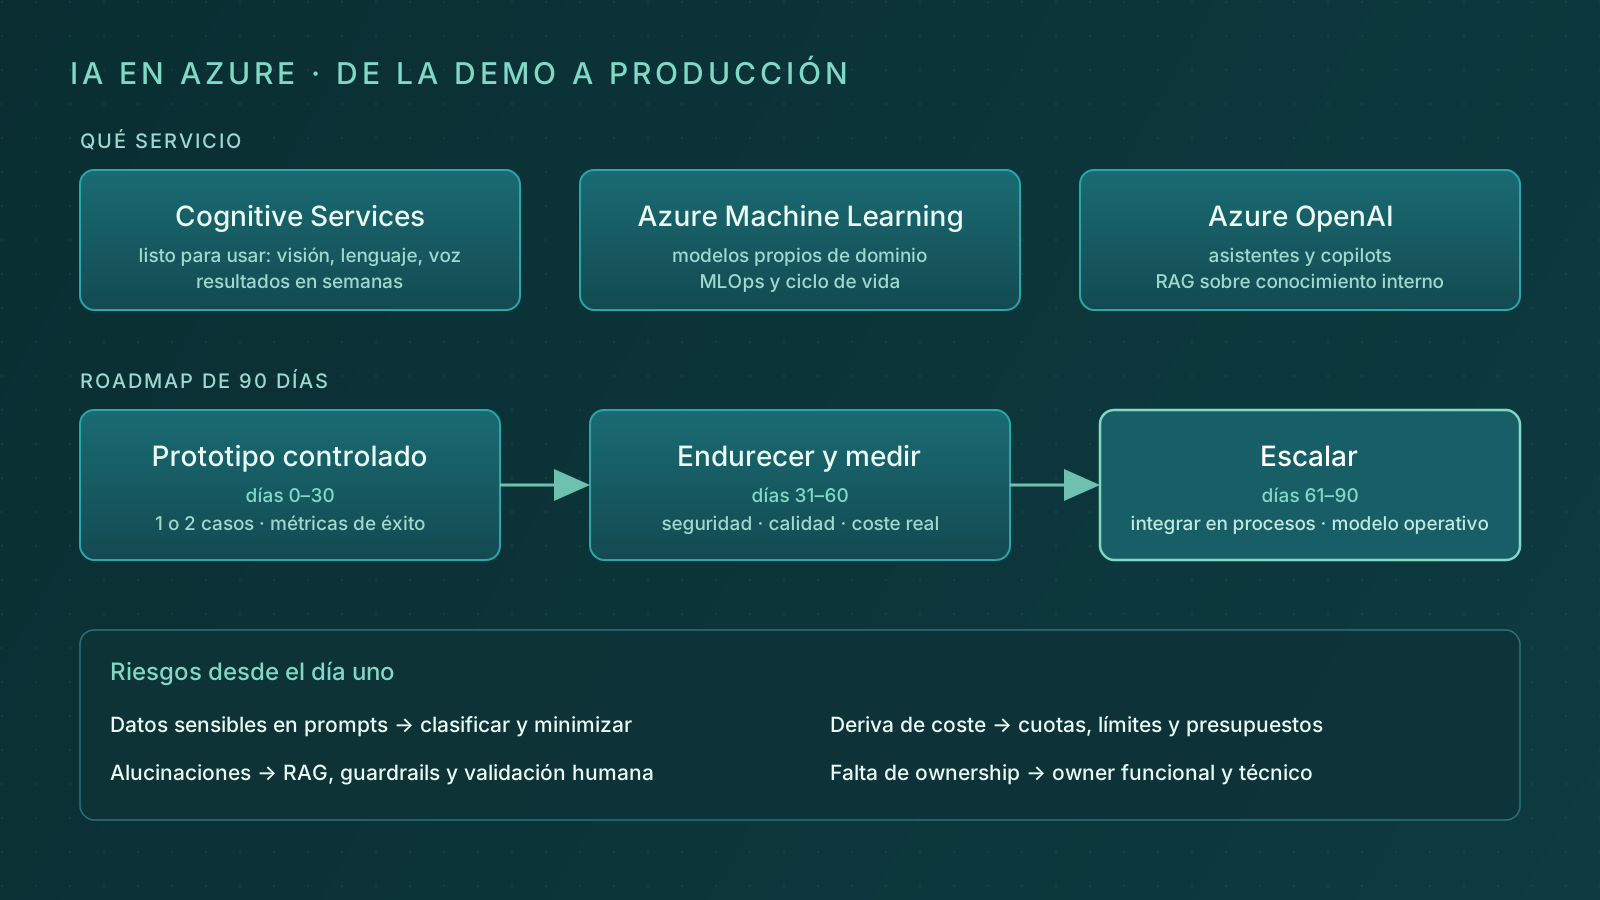
Para llevar un caso de IA en Azure de la demo a producción uso tres decisiones: qué servicio, en qué orden y qué riesgos cubrir antes de escalar. Con eso, el piloto deja de ser una prueba aislada.
Hacer que una demo funcione es fácil. Lo difícil es que siga funcionando con datos reales, con un coste previsible y con alguien que responda cuando falla. Ahí es donde se quedan la mayoría de pilotos.
El servicio se elige en una tarde. Lo que hace que un caso de IA llegue a producción es la operación: datos, seguridad, coste y ownership.
Qué servicio para qué
Azure tiene tres familias que cubren casi todos los casos. Elijo según cuánto tengo que construir yo.
| Servicio | Para qué | Cuándo encaja |
|---|---|---|
| Azure AI Services | Visión, lenguaje, traducción y voz, listos para usar | Quiero resultados en semanas y no entreno nada |
| Azure Machine Learning | Entrenar, versionar y desplegar modelos propios | El problema pide un modelo de dominio y hay equipo de datos |
| Azure OpenAI | Asistentes, extracción y generación de texto | Necesito un asistente sobre conocimiento interno |
Azure AI Services
Microsoft la llamaba antes Cognitive Services. Son APIs ya entrenadas: OCR, extracción de entidades, traducción o transcripción de voz.
Es la opción más rápida. Si el caso cabe en lo que ofrecen, no tiene sentido entrenar un modelo propio.
Azure Machine Learning
Es la plataforma para el ciclo de vida completo de un modelo propio: entrenar, versionar, desplegar y reentrenar. Aquí entra el MLOps.
Encaja cuando el problema es de dominio, como una predicción o un scoring con datos de la empresa. Exige un equipo con capacidad de ciencia de datos y de operación.
Azure OpenAI
Da acceso a modelos generativos dentro de Azure, con la identidad y la red de la propia suscripción. Es la base para asistentes y copilots.
El patrón más útil es RAG: el modelo responde con documentos internos recuperados en cada consulta, no con lo que recuerda.
Un asistente generativo no sustituye a una API de extracción. Si el caso es leer facturas, un servicio ya entrenado suele ser más barato y más predecible.
Tres patrones que se repiten
Casi todo lo que veo encaja en uno de estos tres:
- Automatización documental: OCR, extracción de entidades y clasificación, con validación semiautomática. Reduce trabajo manual y errores repetitivos.
- Asistente interno con RAG: ingesta de documentos, recuperación por contexto y respuesta asistida para soporte u operaciones.
- Predicción operativa: forecasting o scoring conectado a dashboards y alertas, con reentrenamiento controlado.
El primero suele salir con Azure AI Services, el segundo con Azure OpenAI y el tercero con Azure Machine Learning.
Roadmap de 90 días
Divido la adopción en tres tramos de un mes. Cada uno tiene un objetivo distinto y no se pasa al siguiente sin cerrarlo.
Días 0–30: prototipo controlado
Elijo uno o dos casos de alto valor, no más. Antes de construir nada, fijo las métricas de éxito: qué calidad, qué latencia y qué coste por consulta se aceptan.
El prototipo trabaja con datos reales pero acotados, y con usuarios que saben que es una prueba.
Días 31–60: endurecer y medir
Aquí entran la seguridad y la observabilidad. Mido la calidad y el coste reales, no los de la demo, y ajusto prompts y flujos con esos datos.
El coste de la demo no predice el de producción. Los usuarios reales hacen preguntas más largas y más veces de lo que se prueba.
Días 61–90: escalar
Con las métricas en verde, amplío a un equipo o un área. Integro el caso en los procesos que ya existen y fijo el modelo operativo: quién lo mantiene, cómo se mejora y qué se hace si falla.
Cuatro riesgos desde el día uno
Estos cuatro aparecen en casi todos los pilotos. Los cubro desde el principio porque añadirlos después cuesta el doble.
| Riesgo | Mitigación |
|---|---|
| Datos sensibles en prompts | Clasificar los datos, minimizar lo que se envía y registrar sin datos personales |
| Respuestas alucinadas | Contexto controlado con RAG, guardrails por dominio y validación humana en tareas críticas |
| Deriva de coste | Cuotas, límites y presupuestos, con observabilidad por caso de uso |
| Falta de ownership | Un owner funcional y uno técnico por caso, con un nivel de calidad acordado |
El que más se subestima es el último. Un caso sin owner se degrada en silencio hasta que alguien deja de usarlo.
Para la deriva de coste aplico lo mismo que en el resto del cloud. Lo cuento en Observabilidad FinOps en AWS: detectar desvíos a tiempo.
Un gobierno mínimo
No hace falta burocracia, pero sí cuatro reglas escritas:
- Un catálogo de casos de uso aprobados.
- Qué datos se pueden usar y cuáles no.
- Criterios de evaluación: calidad, latencia, coste y riesgo.
- Un procedimiento para cuando algo sale mal.
Sin estas reglas, un piloto puede dar valor puntual, pero no escala con confianza.
Lo que aprendí
Elegir el servicio es la parte fácil. Lo que separa una demo de producción es fijar las métricas antes del prototipo y poner un owner con nombre antes de escalar.
Relacionado: Azure vs AWS: cómo elegir cloud con criterio · De prototipo LLM a plataforma operable
Si tienes dudas o lo estás montando tú, cuéntamelo.