El problema
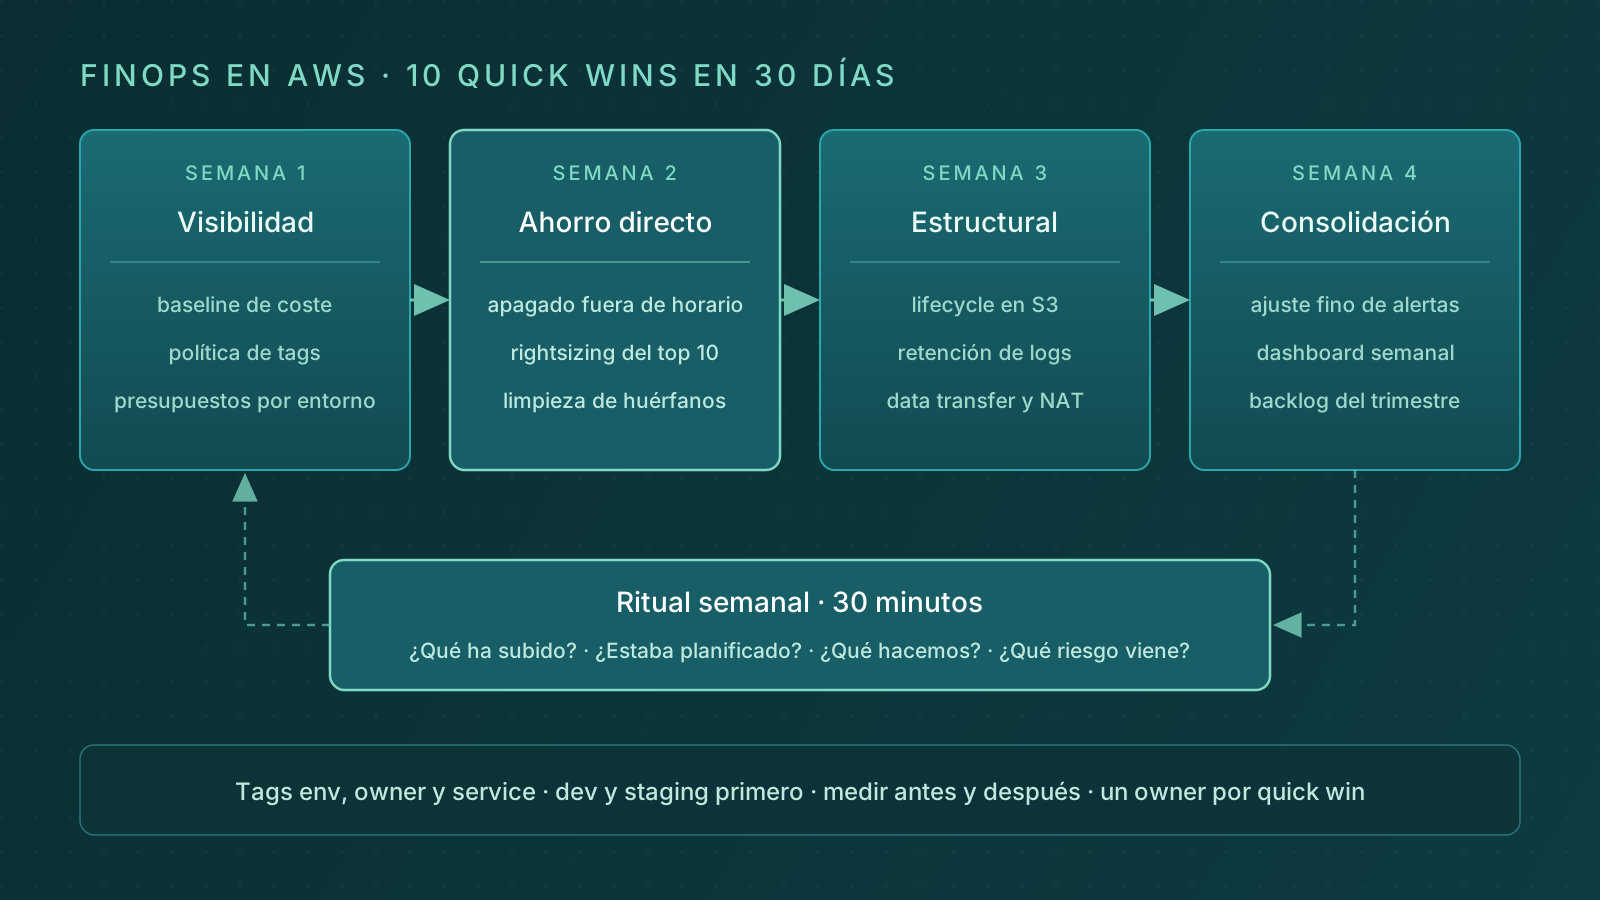
Con este plan recorto el gasto de AWS de un equipo pequeño en un mes y sin frenar el roadmap. Son 10 acciones de bajo riesgo en cuatro semanas, más un ritual semanal que evita que el gasto vuelva.
AWS ya trae Budgets, Cost Explorer y recomendaciones de rightsizing. Lo que suele faltar es un orden: qué se mira primero, qué se toca después y quién decide cada cambio.
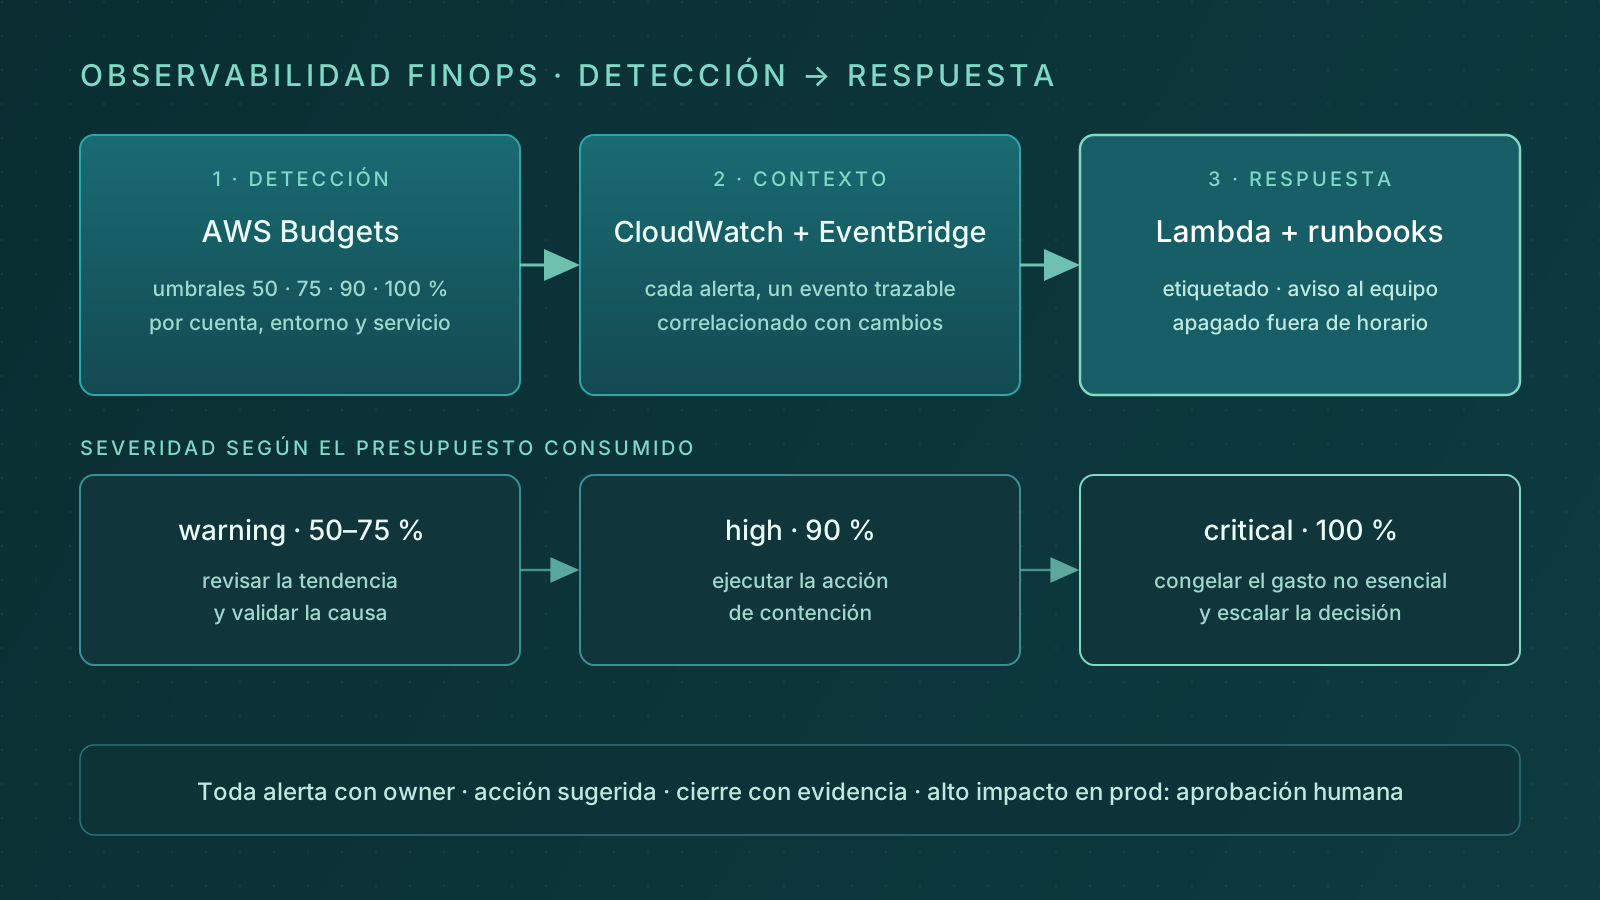
Este post va de qué recortar y en qué orden. Cómo vigilar después que el gasto no se dispare lo cuento en Observabilidad FinOps en AWS: detectar desvíos a tiempo.
Primero se mide y después se recorta. Un ahorro que no se puede atribuir a nadie vuelve en pocas semanas.
Cuatro reglas antes de tocar nada
- Empiezo por
devystaging. Producción, solo con ventana y vuelta atrás. - Ordeno los recursos por coste y empiezo por arriba.
- Mido antes y después de cada acción, con la misma vista de Cost Explorer.
- Cada quick win tiene un owner, con nombre y apellido.
Semana 1: visibilidad
1. Baseline y tres etiquetas
Antes de recortar guardo la baseline: el gasto de los últimos tres meses por servicio. Es la cifra contra la que mido el resto del mes.
Después fijo tres etiquetas: env, owner y service. Con más etiquetas baja el cumplimiento. En Terraform las pongo con default_tags en el provider, así ningún recurso que cree Terraform sale sin ellas.
Una etiqueta no aparece en Cost Explorer hasta que la activas como cost allocation tag en la consola de Billing.
2. Un presupuesto por entorno
Creo un presupuesto mensual para cada entorno, filtrado por env. Esta semana no ahorra nada, pero me dirá si lo que viene funciona. Los umbrales, las severidades y a quién avisa cada uno viven en el post de observabilidad enlazado arriba.
Semana 2: ahorro directo
3. Apagar dev y staging fuera de horario
Es el quick win con mejor relación entre impacto y esfuerzo. Pongamos un entorno que se usa unas 50 horas de las 168 semanales: pasa casi el 70 % del tiempo encendido sin uso.
Lo monto con EventBridge Scheduler y una Lambda que para y arranca por la etiqueta env. Empiezo con una lista corta de recursos y la amplío cuando nadie echa nada en falta.
Una instancia parada sigue pagando sus volúmenes EBS. Y una base de datos RDS parada vuelve a arrancar sola a los siete días.
4. Rightsizing del top 10
No reviso todo a la vez. Tomo los diez recursos más caros y miro de 2 a 4 semanas de uso con Compute Optimizer. Para ver la memoria hace falta el agente de CloudWatch en la instancia.
Bajo un tamaño cada vez y mido rendimiento y coste antes del siguiente paso.
5. Graviton donde encaje
En cargas compatibles, las instancias Graviton suelen dar mejor coste por rendimiento. Hago un piloto en un servicio estable, con una imagen multiarquitectura, y comparo latencia y coste por petición. Solo escalo si el resultado se repite.
6. Limpiar huérfanos
Volúmenes sin adjuntar, snapshots sin política y Elastic IPs sin asociar. No duelen un día concreto, pero se acumulan durante meses. Para encontrar los volúmenes basta un comando:
# terminal: volúmenes EBS sin adjuntar a ninguna instancia (estado available)
aws ec2 describe-volumes --region eu-central-1 \
  --filters Name=status,Values=available \
  --query 'Volumes[].[VolumeId,Size,VolumeType,CreateTime]' \
  --output table
Antes de borrar, hago un snapshot y aviso al owner. Un volumen suelto puede ser el disco que alguien desmontó para una prueba.
Semana 3: ahorro estructural
7. Ciclo de vida en S3
Muchos datos que casi nunca se consultan se pagan como datos calientes. Una regla de ciclo de vida los mueve a clases más baratas sin tocar la aplicación.
# s3-lifecycle.tf — ejemplo: logs a clases frías y borrado al año
resource "aws_s3_bucket_lifecycle_configuration" "demo_logs" {
  bucket = "demo-logs-123456789012" # bucket que ya existe, creado fuera de este fichero

  rule {
    id     = "logs-a-frio"
    status = "Enabled"

    filter {
      prefix = "logs/"
    }

    transition {
      days          = 30
      storage_class = "STANDARD_IA"
    }

    transition {
      days          = 90
      storage_class = "GLACIER_IR"
    }

    expiration {
      days = 365
    }

    abort_incomplete_multipart_upload {
      days_after_initiation = 7
    }
  }
}
Los días son de ejemplo: cada prefijo necesita los suyos según cuánto se consulta.
Las clases frías cobran una duración mínima y, por defecto, el ciclo de vida no mueve objetos de menos de 128 KB. Con muchos ficheros pequeños, el ahorro puede ser nulo.
8. Retención de logs
Un grupo de CloudWatch Logs nuevo no caduca nunca. Fijo la retención por tipo: larga para seguridad y auditoría, corta para logs operativos y más corta aún fuera de producción.
9. Data transfer y NAT
La transferencia y el NAT Gateway son coste silencioso. Reviso el tráfico entre zonas y el que sale por el NAT. Los endpoints de gateway para S3 y DynamoDB no cuestan nada y sacan ese tráfico del NAT.
Semana 4: consolidación
10. El ritual semanal de 30 minutos
Sin cadencia, el ahorro se degrada. Cada semana abro Cost Explorer agrupado por service y env y respondo cuatro preguntas:
- ¿Qué ha subido?
- ¿Estaba planificado?
- ¿Qué hacemos esta semana, y quién?
- ¿Qué riesgo de coste viene en las próximas dos semanas?
A la reunión llegan también las alertas de la semana, ya con owner y severidad. De dónde salen lo explico en Observabilidad FinOps en AWS: detectar desvíos a tiempo.
El resto de la semana cierra el mes. Ajusto los umbrales que dieron falsas alarmas, dejo un dashboard semanal y apunto lo pendiente en el backlog del trimestre.
Los Savings Plans van al backlog, no a la primera semana. Comprometer gasto antes de recortar es comprometerse con el desperdicio.
- Baseline guardada y etiquetas
env,owneryserviceactivadas. - Un presupuesto por entorno.
- Dev y staging apagados fuera de horario.
- Top 10 revisado y huérfanos limpiados.
- Ciclo de vida en S3 y retención de logs fijados.
- Ritual semanal en el calendario, con owner por acción.
Tres de estas acciones, con el ahorro medido antes y después, están en el proyecto Optimización de costes en AWS.
Lo que aprendí
El orden importa más que la lista. Sin las etiquetas de la primera semana, cada ahorro de la segunda se quedaba sin dueño y el gasto volvía al mes siguiente.
Si tienes dudas o lo estás montando tú, cuéntamelo.