El problema
Llevé a Terraform el data lake de Arquitectura ETL de 3 capas en AWS con Glue y Athena. Ahora un cambio en un bucket, un job o un workgroup pasa por un PR y se aplica igual en dev, staging y prod.
A mano, el primer entorno sale bien. El problema llega con el segundo: un permiso añadido en la consola o una ruta distinta en un job, y los entornos dejan de parecerse.
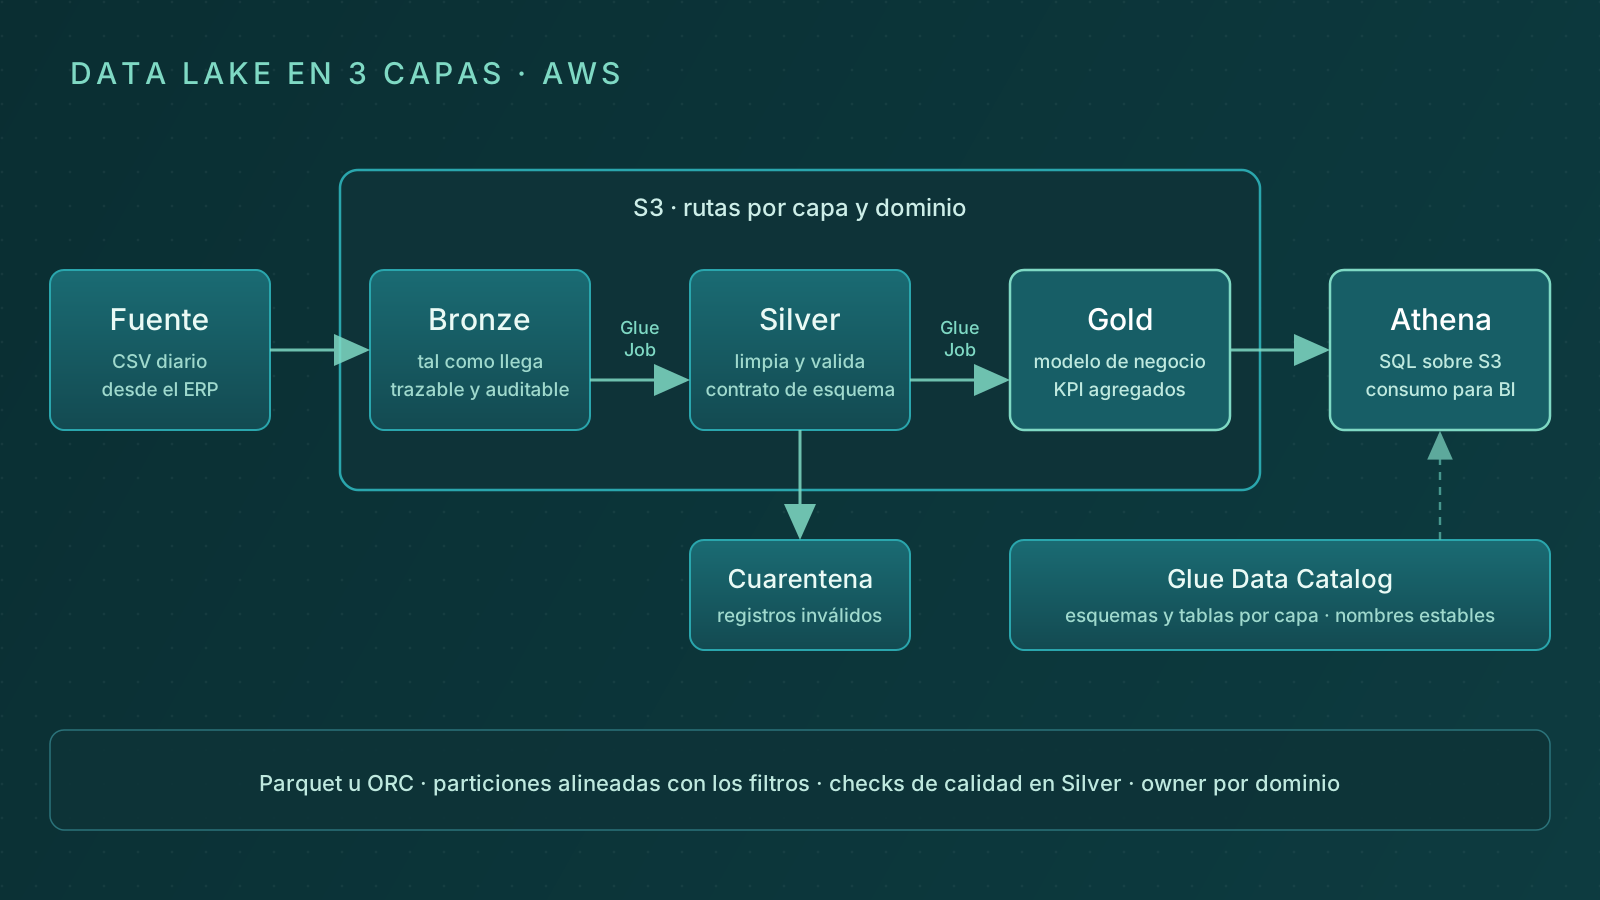
Las capas, la cuarentena y las particiones están explicadas en ese post. Aquí va solo cómo se despliega y cómo se cambia. El lab completo es ETL serverless con Terraform.
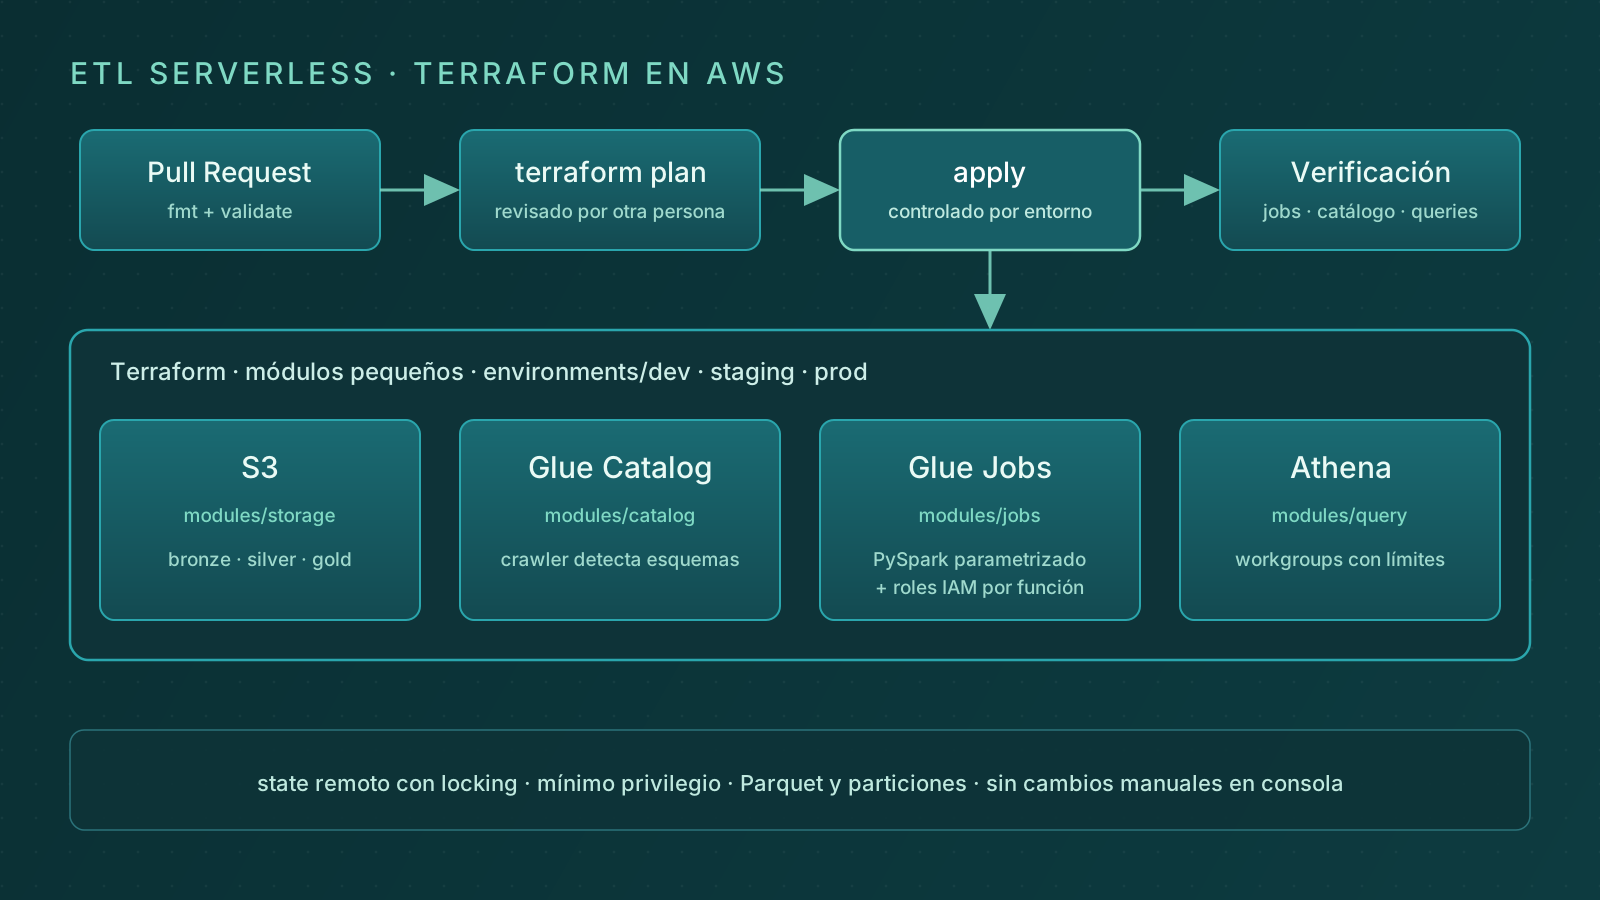
El entorno solo decide valores. Qué recursos existen y cómo se configuran lo deciden los módulos.
Cuatro módulos, un trabajo cada uno
| Módulo | Qué crea |
|---|---|
modules/storage | el bucket con un prefijo por capa, cifrado y sin acceso público |
modules/catalog | una base de Glue por capa, las tablas de Silver y Gold y el crawler de Bronze |
modules/jobs | los Glue Jobs, sus scripts en S3 y un rol IAM por job |
modules/query | el workgroup de Athena y dónde guarda los resultados |
Prefiero cuatro módulos pequeños a uno grande. Un cambio en el workgroup no tiene por qué aparecer en el mismo plan que los jobs.
Las tablas de Silver y Gold las defino en código, porque su esquema es el contrato. El crawler solo corre sobre Bronze, donde el esquema lo decide la fuente.
Un crawler sobre Silver puede cambiar el tipo de una columna sin pasar por ningún PR. Y lo que consume esa tabla se entera tarde.
Un directorio por entorno
environments/dev, staging y prod tienen los mismos tres ficheros: backend.tf, main.tf y los valores del entorno. Llaman a los mismos módulos con valores distintos.
# environments/dev/main.tf: las variables las declara cada modules/*/variables.tf
locals {
  env    = "dev"
  bucket = "demo-datalake-${local.env}-123456789012"
}

module "storage" {
  source      = "../../modules/storage"
  bucket_name = local.bucket
  layers      = ["bronze", "silver", "gold", "quarantine"]
}

module "jobs" {
  source      = "../../modules/jobs"
  env         = local.env
  bucket_name = module.storage.bucket_name # output de modules/storage
}

module "query" {
  source               = "../../modules/query"
  env                  = local.env
  results_bucket       = module.storage.bucket_name
  bytes_scanned_cutoff = 1073741824 # 1 GiB por consulta en dev
}
El módulo de jobs construye las rutas de cada capa a partir del bucket. Al job le llegan como argumentos (--BRONZE_PATH, --SILVER_PATH), así que el mismo script sirve en los tres entornos.
State remoto con bloqueo
Cada entorno guarda su state en S3, con una clave propia. Un apply en dev no puede tocar el state de prod, y dos applies a la vez sobre el mismo entorno se bloquean.
# environments/dev/backend.tf: state en S3 con bloqueo nativo, sin DynamoDB
terraform {
  required_version = ">= 1.11"

  backend "s3" {
    bucket       = "demo-tfstate-123456789012"
    key          = "etl/dev/terraform.tfstate"
    region       = "eu-central-1"
    encrypt      = true
    use_lockfile = true
  }
}El bloque backend no admite variables. Por eso cada entorno tiene su propio backend.tf, en vez de un único fichero con la clave parametrizada.
De PR a apply
- El PR pasa
terraform fmt -checkyterraform validateen CI. - CI genera
terraform plan -out=tfplanpara cada entorno y lo deja en el PR. Otra persona lo revisa. - Tras el merge, se aplica ese mismo
tfplan: primero dev, después staging y al final prod. - Verifico cada entorno: lanzo el job una vez, compruebo las tablas en el catálogo y ejecuto una consulta conocida en el workgroup.
Aplicar el plan guardado, y no un apply a secas, garantiza que se aplica lo revisado. Si el state cambió entretanto, Terraform rechaza el plan por obsoleto y hay que generarlo de nuevo.
Los gates de calidad y la vuelta atrás de un pipeline los cuento en Pipeline CI/CD en AWS con rollback automático.
Un rol IAM por función
Cada job tiene su rol. Lee su prefijo de entrada, escribe en el de salida y en cuarentena, y no ve nada más. El crawler solo puede leer Bronze.
Los roles viven en el mismo módulo que el recurso que los usa. Así un job nuevo no puede salir sin su rol, y borrar el job se lleva también sus permisos.
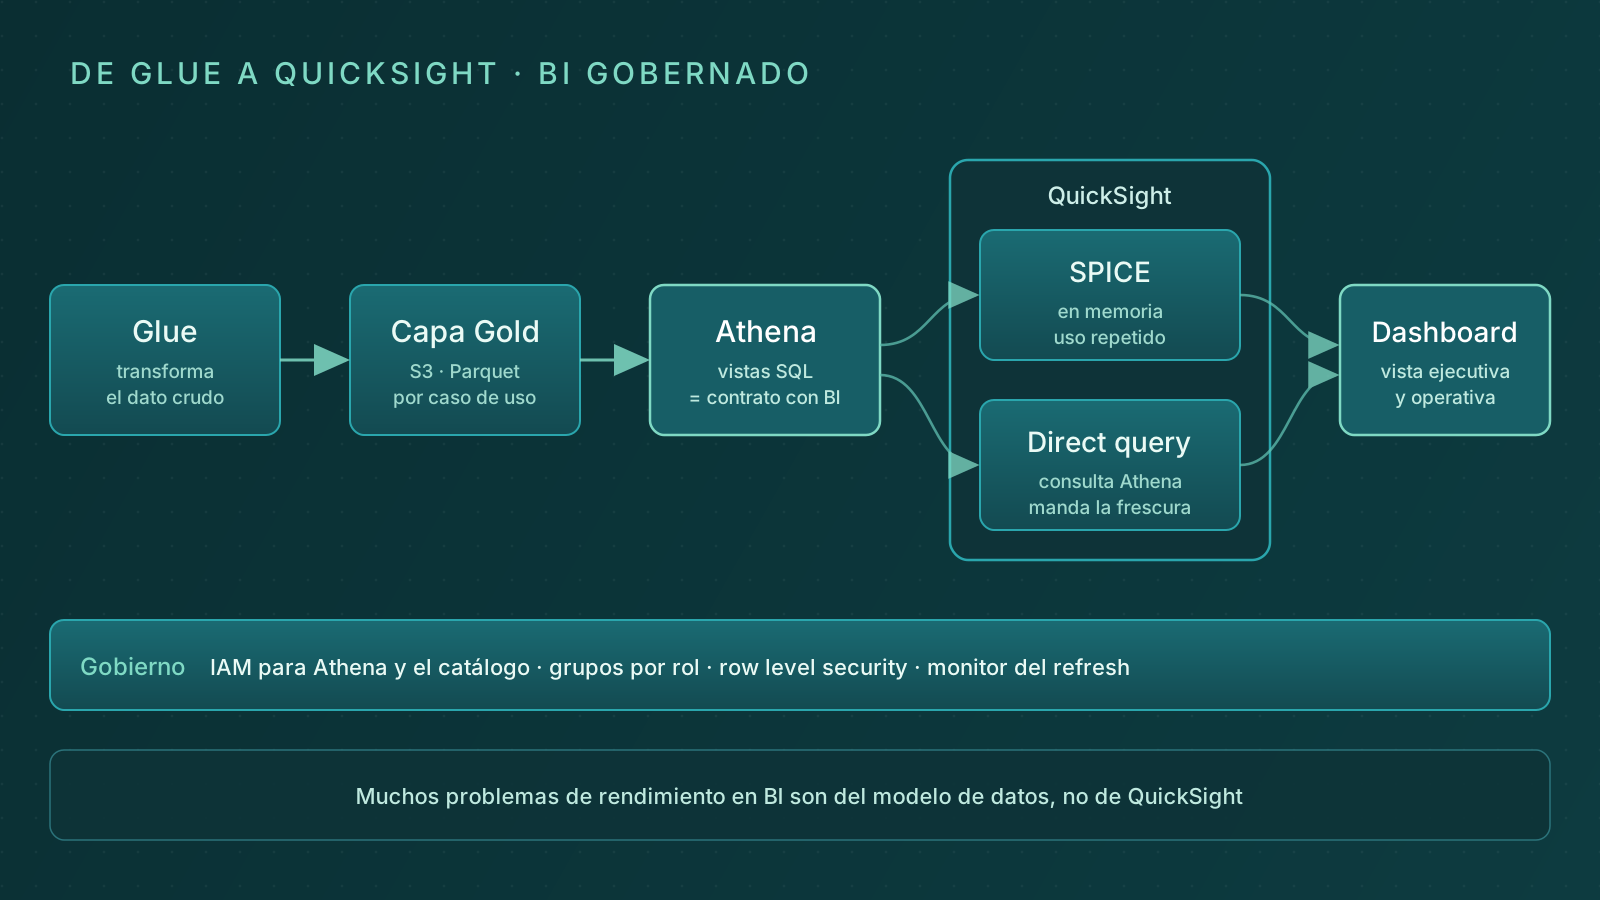
El acceso de BI a la capa Gold es otra historia, y la cuento en De Glue a QuickSight: dashboards que sí se usan.
Un tope de escaneo en Athena
El formato y las particiones reducen lo que lee una consulta. El workgroup pone el límite cuando aun así alguien lanza una consulta que lo lee todo.
# modules/query/main.tf: workgroup con tope por consulta que el cliente no puede saltarse
resource "aws_athena_workgroup" "this" {
  name = "${var.env}-analytics"

  configuration {
    enforce_workgroup_configuration = true
    bytes_scanned_cutoff_per_query  = var.bytes_scanned_cutoff

    result_configuration {
      output_location = "s3://${var.results_bucket}/athena-results/"
    }
  }
}
Una consulta que pasa del tope se cancela, y solo se paga lo escaneado hasta ese momento. En dev el tope es bajo a propósito: si una consulta lo toca allí, la reviso antes de que llegue a prod.
Sin cambios en consola
En consola solo se toca en una emergencia, y ese cambio vuelve al código el mismo día. Para detectar lo que se escape, un terraform plan -detailed-exitcode programado devuelve 2 cuando hay diferencias.
- Un state por entorno, en S3 y con
use_lockfile. - Tablas de Silver y Gold en código; el crawler, solo en Bronze.
- Rutas de los jobs como argumentos, nunca escritas en el script.
- Un rol IAM por job y por crawler.
- Workgroup con
enforce_workgroup_configurationy tope por entorno. - Plan guardado, revisado en el PR y aplicado tal cual.
Lo que aprendí
Dejar el crawler solo en Bronze fue lo que más estabilizó los entornos. Con él en Silver, un fichero raro cambiaba un tipo sin pasar por ningún PR, y nadie lo veía hasta que fallaba una consulta.
Si tienes dudas o lo estás montando tú, cuéntamelo.