El problema
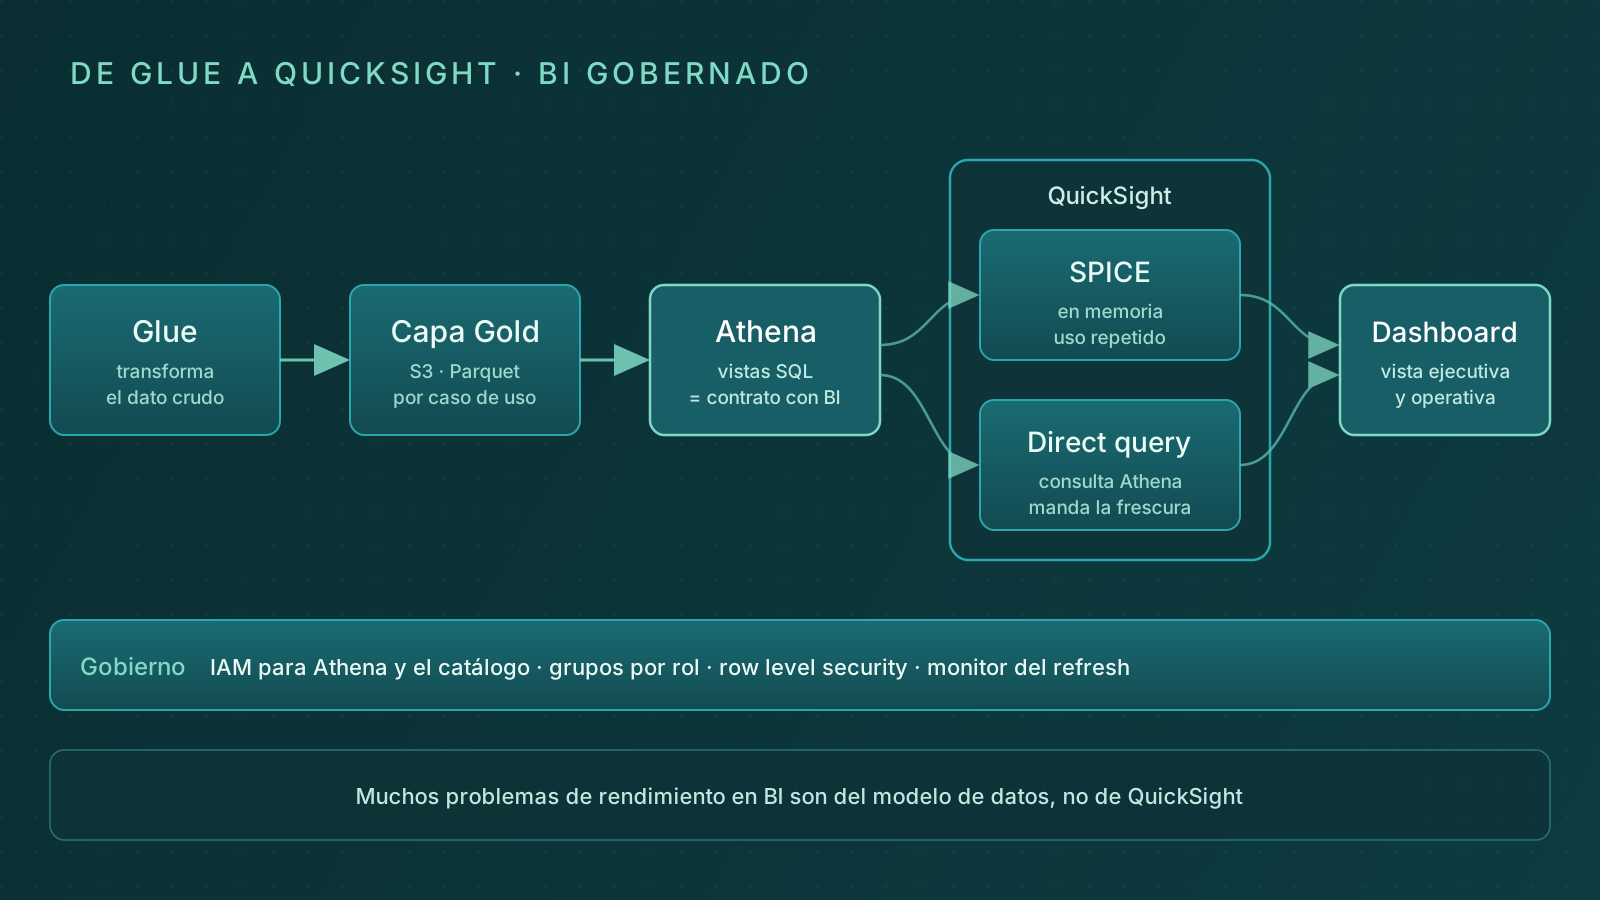
Conecté la capa Gold de mi lab a QuickSight. Cada métrica se define una vez y da lo mismo en todos los dashboards. Si cambio una tabla de Gold, el dashboard no se entera mientras la vista mantenga su forma.
El fallo típico no es técnico. El ETL carga, pero cada analista calcula «ventas» a su manera en un campo calculado, y dos paneles dan cifras distintas. A partir de ahí, nadie se fía de ninguno.
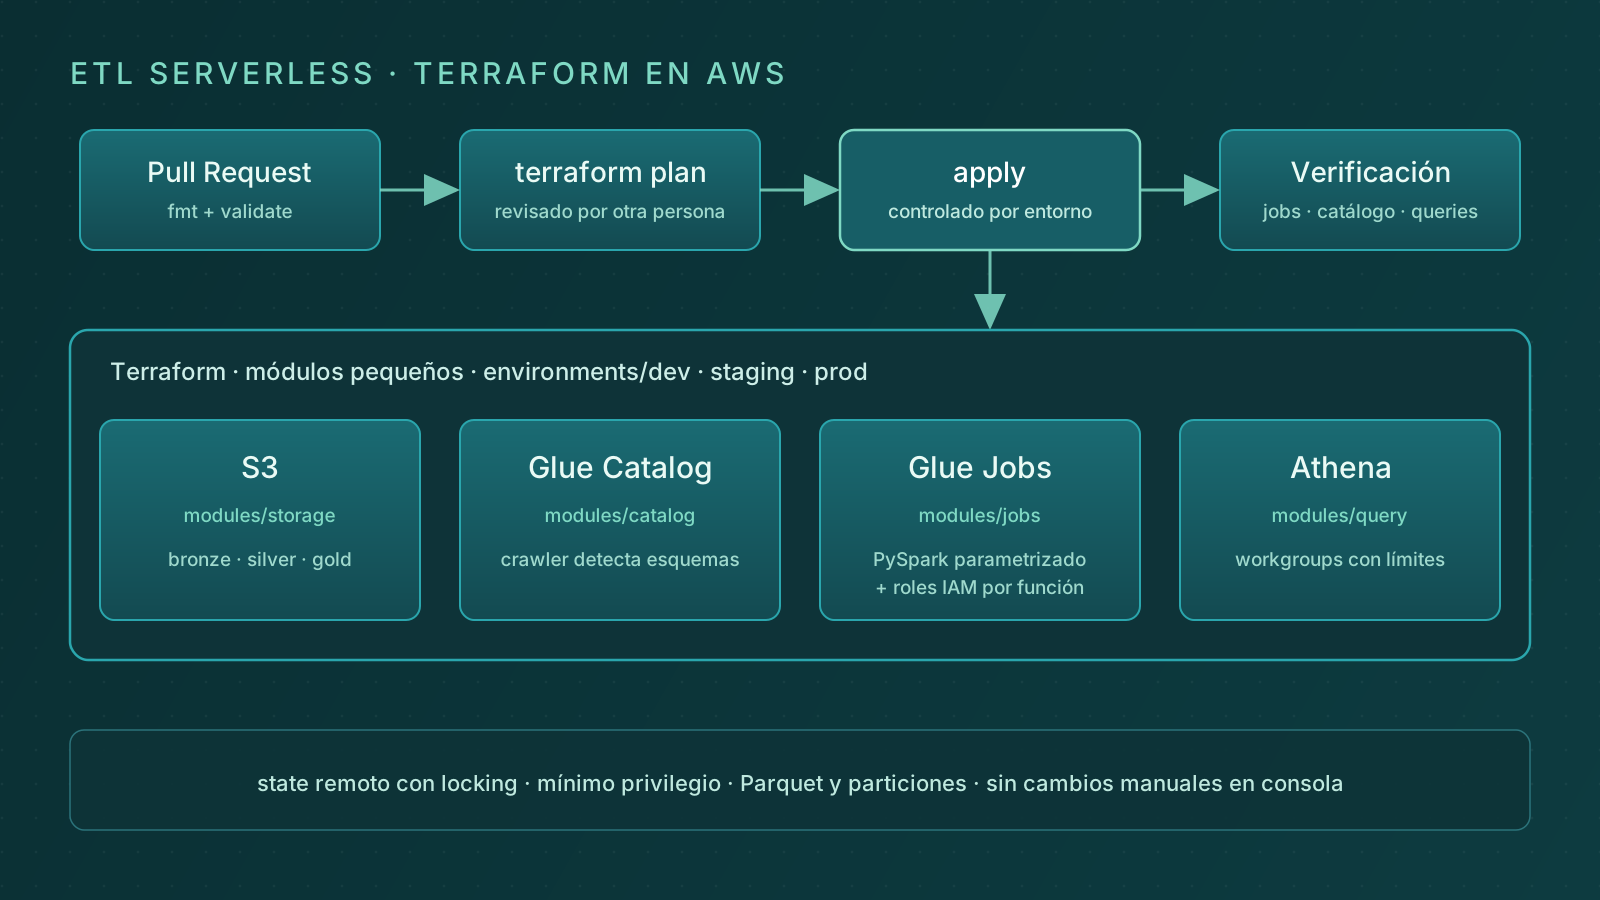
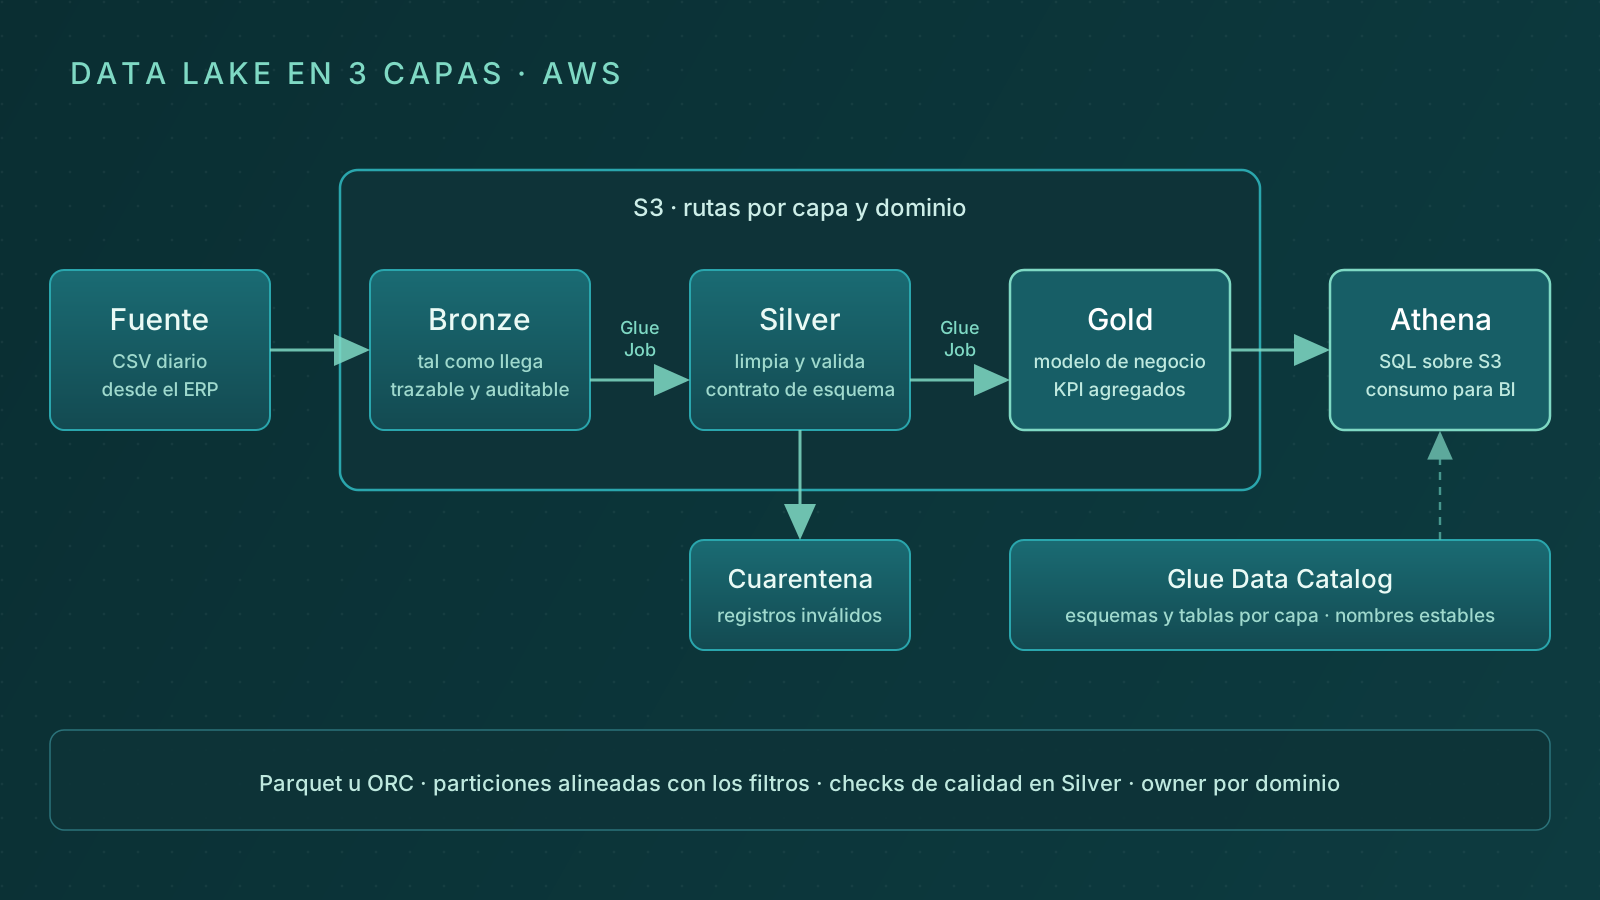
Este post cierra el recorrido. El diseño de las capas está en Arquitectura ETL de 3 capas en AWS con Glue y Athena. Su despliegue, en ETL serverless en AWS gestionado con Terraform.
Si la métrica vive en el dashboard, habrá tantas versiones como dashboards. Si vive en la vista, hay una.
La vista de Athena es el contrato
QuickSight no apunta a las tablas de Gold, sino a vistas de Athena. La vista fija qué columnas hay, cómo se llaman, de qué tipo son y cómo se calcula cada métrica.
-- athena: vista de consumo para BI sobre la tabla Gold demo_gold.ventas_diarias
CREATE OR REPLACE VIEW demo_gold.v_ventas_diarias AS
SELECT
  CAST(fecha AS date)                    AS fecha,
  canal,
  pais,
  CAST(pedidos AS bigint)                AS pedidos,
  CAST(importe_total AS decimal(14, 2))  AS importe_total,
  CAST(importe_total / NULLIF(pedidos, 0) AS decimal(12, 2)) AS ticket_medio
FROM demo_gold.ventas_diarias;
El ticket medio se calcula aquí y en ningún otro sitio. En QuickSight, el dataset solo da formato: no redefine ninguna métrica con campos calculados.
Debajo de la vista puedo renombrar una columna o reorganizar la tabla. Mientras la vista devuelva lo mismo, ningún dashboard se rompe.
Una vista con SELECT * fija la lista de columnas al crearse. Si la tabla cambia, la vista puede fallar como obsoleta. Columnas explícitas, y la vista se recrea en el mismo PR que la tabla.
SPICE o direct query
| SPICE | Direct query | |
|---|---|---|
| De dónde lee el dashboard | una copia en memoria de QuickSight | Athena, en cada interacción |
| Frescura | la del último refresh | la de la capa Gold |
| Coste | capacidad de SPICE | lo que escanea cada consulta |
| Lo uso para | dashboards que se abren a menudo | datos que cambian varias veces al día |
Mi opción por defecto es SPICE. Abrir el dashboard no lanza consultas a Athena, y un dashboard que se usa mucho no multiplica el escaneo.
Direct query solo compensa cuando la frescura importa más que la latencia. Cada visual y cada filtro lanzan su propia consulta. El tope de escaneo del workgroup, del post anterior, es lo que evita una sorpresa en la factura.
Con tablas grandes, SPICE admite refresh incremental para fuentes SQL como Athena. Solo recarga una ventana reciente según una columna de fecha.
Un refresh a hora fija puede empezar antes de que termine el job de Gold. El dashboard muestra entonces el dato de ayer sin avisar.
Por eso no programo el refresh por hora. Una regla de EventBridge escucha el cambio de estado del job de Gold y, cuando acaba bien, una Lambda llama a CreateIngestion del dataset.
Si va lento, mira primero Gold
En mis pruebas, cuando un dashboard iba lento, la causa era el modelo y no QuickSight. Una tabla Gold preagregada y con pocas columnas es más rápida que cualquier ajuste en el visual.
Por qué Gold se preagrega y se particiona por fecha está en el post del diseño. En QuickSight solo me queda una regla: pocos visuales por hoja, porque cada uno es una consulta.
Gobierno: quién ve qué
Para que se use, el dashboard tiene que ser fiable, y también tiene que enseñar a cada uno solo lo suyo. Lo resuelvo en tres capas.
- IAM. El rol de servicio de QuickSight lee el catálogo de Glue, consulta en el workgroup de BI y lee solo el prefijo
gold/del bucket. Escribe únicamente donde Athena guarda los resultados. - Grupos. Los autores crean análisis y los lectores solo ven dashboards publicados. Los permisos se dan a grupos, nunca a personas sueltas.
- Row level security. Un dataset de reglas asocia cada grupo con los valores de
paisque puede ver. Se aplica igual con SPICE y con direct query.
Con RLS activa, quien no aparece en el dataset de reglas no ve ningún dato. Un grupo nuevo sin regla verá el dashboard vacío.
Vigilar el refresh
Un refresh fallido no avisa: el dashboard sigue abriendo, con datos viejos. QuickSight publica en CloudWatch métricas de ingesta por dataset, y una de ellas cuenta los errores.
Pongo una alarma sobre IngestionErrorCount que avisa por SNS. El patrón de alarmas y topics es el de Alertas preventivas en AWS como código con Terraform.
- Una vista por dashboard, con columnas explícitas y las métricas calculadas en ella.
- SPICE por defecto; direct query solo si la frescura lo justifica.
- Refresh disparado al terminar el job de Gold, no a hora fija.
- Rol de QuickSight limitado a Gold y a los resultados de Athena.
- RLS con una regla para cada grupo que debe ver datos.
- Alarma sobre los errores de ingesta.
Lo que aprendí
Llevar el ticket medio de un campo calculado de QuickSight a la vista acabó con las cifras que no cuadraban. Y disparar el refresh al terminar el job, en vez de a una hora fija, quitó los dashboards con el dato de ayer.
Si tienes dudas o lo estás montando tú, cuéntamelo.