El problema
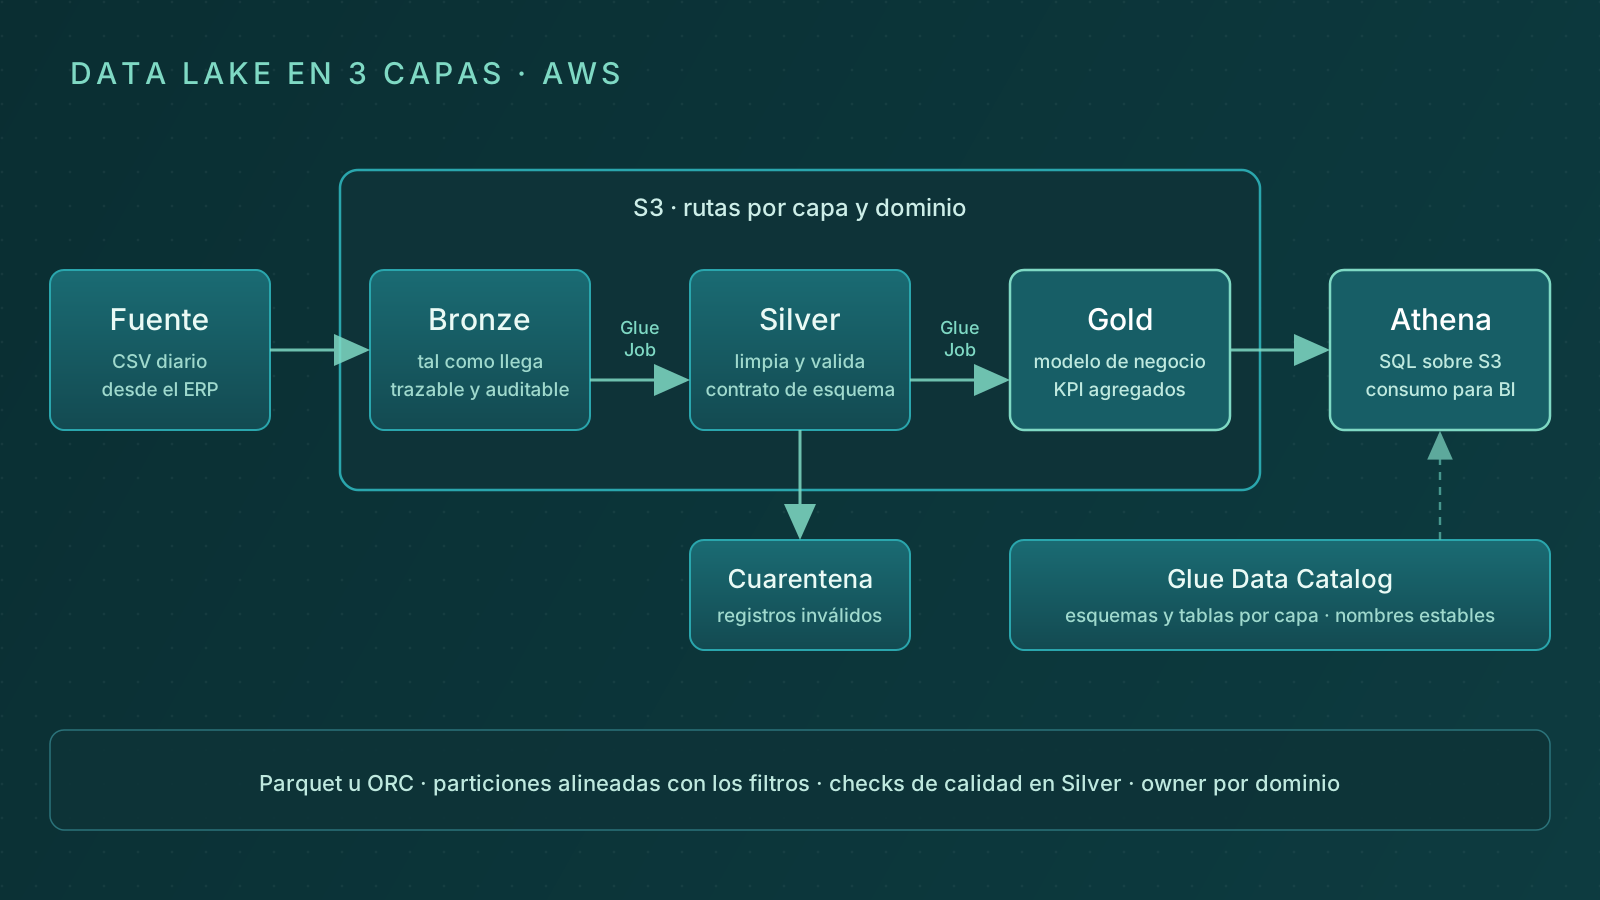
Monté en un lab un data lake de tres capas en S3. Cada cifra de un dashboard se rastrea hasta el fichero que la trajo. Los registros malos no llegan a Gold: se quedan en una cuarentena que puedo revisar.
Cuando ingesta, limpieza y consumo comparten carpeta, un error obliga a reprocesarlo todo. Y nadie sabe si una cifra rara viene de la fuente o de una transformación.
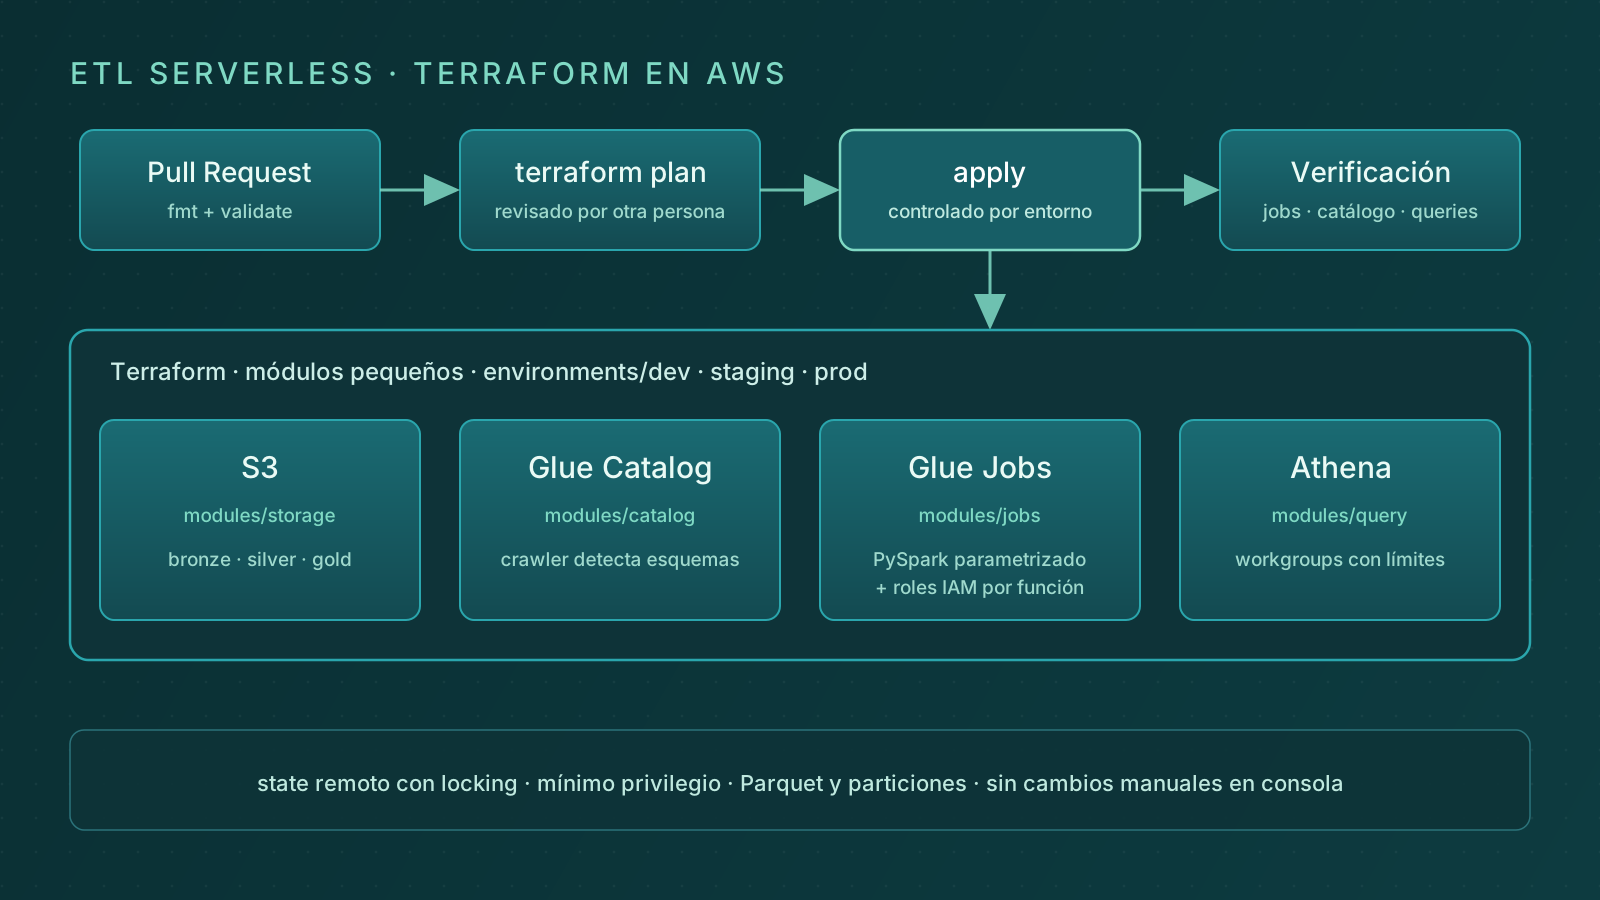
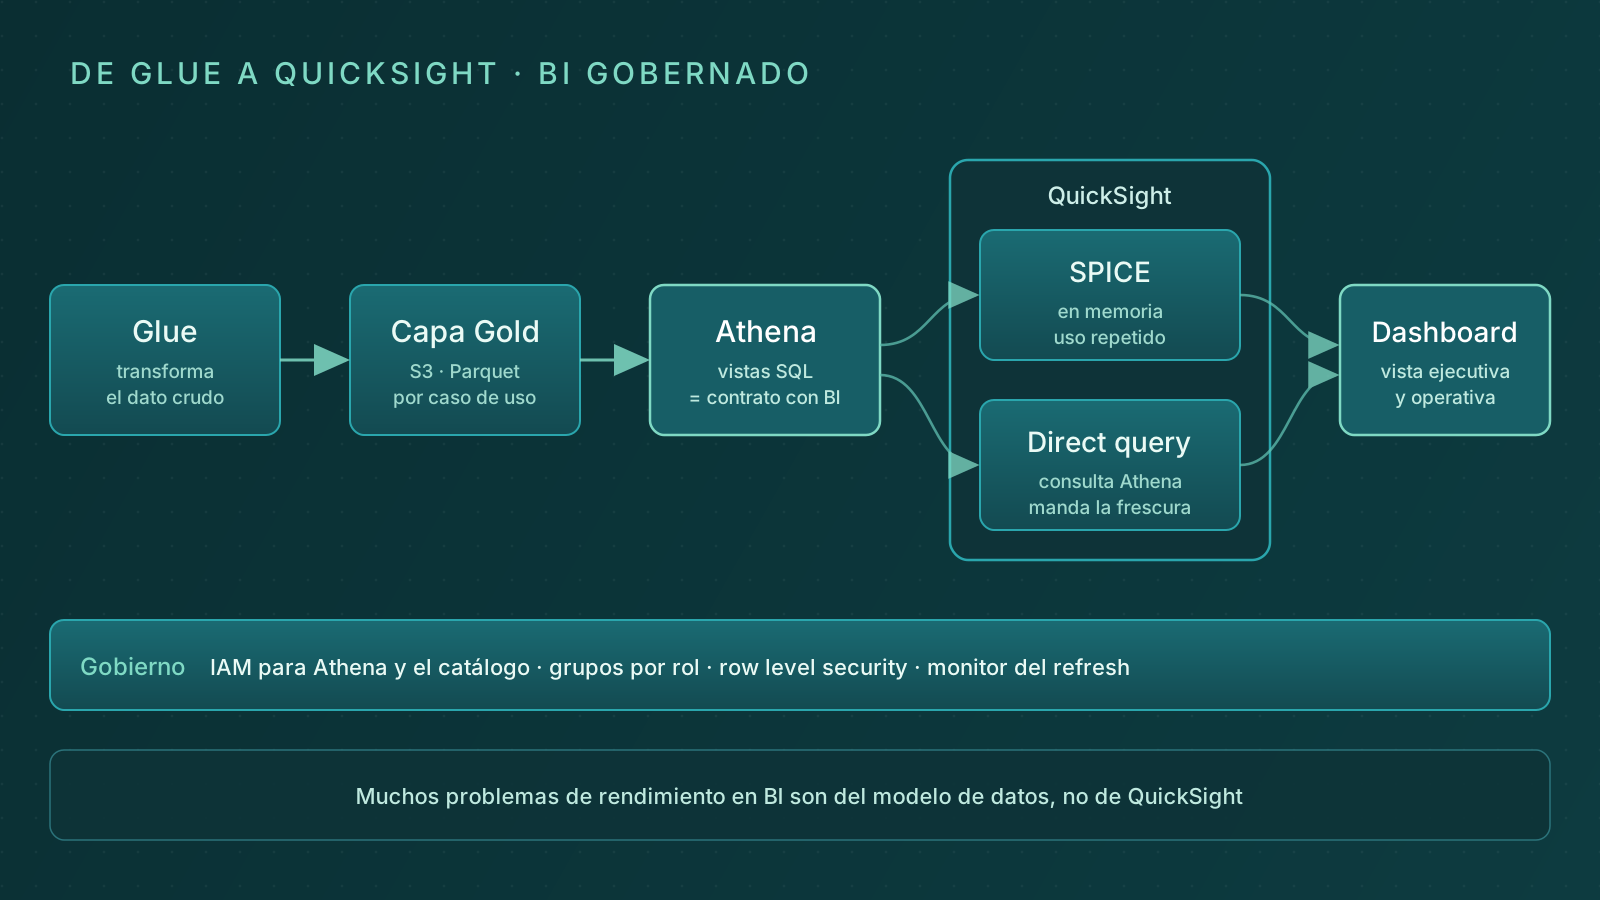
Este post es el diseño. Cómo lo despliego está en ETL serverless en AWS gestionado con Terraform, y cómo llega a los dashboards, en De Glue a QuickSight: dashboards que sí se usan.
Cada capa responde a una pregunta distinta: qué llegó, qué es válido y qué necesita negocio.
Tres capas, un trabajo cada una
- Bronze guarda el dato tal como llega. No lo corrijo: es lo que dijo la fuente, y con él puedo reprocesar cuando quiera.
- Silver tipa, deduplica y valida. Aquí vive el contrato de esquema: nombres, tipos y reglas que todo registro cumple.
- Gold modela para un caso de uso: KPI agregados y solo las columnas que se consultan.
En el lab, la fuente es un CSV diario que exporta un ERP de ejemplo. Entre capas corren dos Glue Jobs: uno de Bronze a Silver y otro de Silver a Gold.
Rutas en S3 por capa y dominio
# estructura del bucket del lab
s3://demo-datalake/bronze/ventas/ingest_date=2026-10-05/ventas.csv
s3://demo-datalake/silver/ventas/year=2026/month=10/day=5/
s3://demo-datalake/gold/ventas_diarias/year=2026/month=10/
s3://demo-datalake/quarantine/ventas/ingest_date=2026-10-05/
Separar por capa y dominio me da permisos por prefijo y el coste de almacenamiento visto por capa. Un job solo necesita leer su entrada y escribir su salida.
Bronze lleva la fecha de ingesta en la ruta. Así sé qué lote trajo cada registro, aunque en Silver se particione por la fecha del pedido.
Silver: validar sin perder nada
Lo que no pasa las reglas no se borra. Va a cuarentena con el motivo del rechazo, y Gold solo lee lo válido. Este es el job que lo separa:
# glue/silver_ventas.py: job Bronze → Silver; el CSV del ERP trae los pedidos de un día
from pyspark.sql import SparkSession, functions as F

spark = SparkSession.builder.getOrCreate()
spark.conf.set("spark.sql.sources.partitionOverwriteMode", "dynamic")

# rutas fijas para leer mejor; en el job real llegan como argumentos
BRONZE = "s3://demo-datalake/bronze/ventas/ingest_date=2026-10-05/"
SILVER = "s3://demo-datalake/silver/ventas/"
QUARANTINE = "s3://demo-datalake/quarantine/ventas/ingest_date=2026-10-05/"

df = spark.read.option("header", True).csv(BRONZE).select(
    "order_id",
    F.to_date("order_date").alias("order_date"),
    "canal",
    F.col("importe").cast("decimal(12,2)").alias("importe"),
)

motivo = (
    F.when(F.col("order_id").isNull(), "sin_order_id")
    .when(F.col("order_date").isNull(), "fecha_invalida")
    .when(F.col("importe").isNull() | (F.col("importe") < 0), "importe_invalido")
)
df = df.withColumn("motivo", motivo)

validos = (
    df.filter(F.col("motivo").isNull())
    .drop("motivo")
    .dropDuplicates(["order_id"])
    .withColumn("year", F.year("order_date"))
    .withColumn("month", F.month("order_date"))
    .withColumn("day", F.dayofmonth("order_date"))
)
rechazados = df.filter(F.col("motivo").isNotNull())

validos.write.mode("overwrite").partitionBy("year", "month", "day").parquet(SILVER)
rechazados.write.mode("overwrite").json(QUARANTINE)
Un importe que no se puede convertir no rompe el job: el cast lo deja en nulo y la regla lo manda a cuarentena. Revisar los rechazos es una consulta, no una búsqueda en logs.
Sin el modo dinámico, overwrite con partitionBy borra todas las particiones de Silver. Con él, reprocesar un día solo reescribe ese día.
Gold: una pregunta, una tabla
El segundo job agrega Silver en ventas_diarias: pedidos e importe por día, canal y país. Gold no es una copia de Silver con otro nombre.
Cada tabla de Gold nace de una pregunta concreta y tiene un owner. Si nadie sabe para qué sirve una columna, sobra. Una tabla pequeña y preagregada es lo que hace rápido un dashboard.
Catálogo y tablas en Athena
El Glue Data Catalog guarda el esquema y la ubicación de cada tabla. Uso una base por capa (demo_bronze, demo_silver y demo_gold) con nombres que no cambian.
-- athena: tabla Silver de ventas sobre Parquet, con proyección de particiones
CREATE EXTERNAL TABLE IF NOT EXISTS demo_silver.ventas (
  order_id   string,
  order_date date,
  canal      string,
  importe    decimal(12,2)
)
PARTITIONED BY (year int, month int, day int)
STORED AS PARQUET
LOCATION 's3://demo-datalake/silver/ventas/'
TBLPROPERTIES (
  'projection.enabled'     = 'true',
  'projection.year.type'   = 'integer',
  'projection.year.range'  = '2024,2030',
  'projection.month.type'  = 'integer',
  'projection.month.range' = '1,12',
  'projection.day.type'    = 'integer',
  'projection.day.range'   = '1,31'
);
Las columnas de partición no van dentro del Parquet: salen de la ruta year=…/month=…/day=… que escribe el job.
Athena no ve una partición nueva hasta que alguien la registra. Con proyección la calcula sola; sin ella hace falta MSCK REPAIR TABLE o un crawler.
Athena: el coste lo decide el diseño
Athena cobra por dato leído, así que el ahorro se decide al escribir, no al consultar. Dos decisiones lo cubren casi todo.
Parquet es columnar y va comprimido. Una consulta que usa tres columnas lee esas tres, no la fila entera como en un CSV.
Las particiones van por el campo que filtran las consultas, que aquí es la fecha. Como ejemplo: con dos años de datos, una consulta de un mes lee alrededor de 1/24 de los ficheros.
El tope de escaneo por consulta va en el workgroup de Athena, y eso ya es parte del despliegue con Terraform.
Glue Job o CTAS
El diseño usa Glue Jobs porque la validación registro a registro se escribe mejor en PySpark. Con poco volumen hay una opción más barata.
En el lab ETL serverless de bajo coste cambié los jobs por consultas CTAS de Athena que escriben Parquet. Las capas son las mismas; solo cambia el motor.
Lo que aprendí
La cuarentena cambió la conversación sobre calidad: en vez de «faltan datos», había una tabla con cada rechazo y su motivo. Y el modo de sobrescritura de Spark era la diferencia entre reprocesar un día y vaciar Silver.
Si tienes dudas o lo estás montando tú, cuéntamelo.