El problema
Monté un juego mínimo de alertas preventivas para EC2 como código: cuatro alarmas, dos severidades, un topic SNS por entorno y un despliegue por fases. Antes de escribir una línea de Terraform, decidí qué alertar, cómo nombrarlo y en qué orden desplegarlo.
Crear alarmas a mano en la consola está bien para aprender. El problema llega con el segundo entorno: nadie sabe quién cambió un umbral, ni por qué staging y prod ya no coinciden.
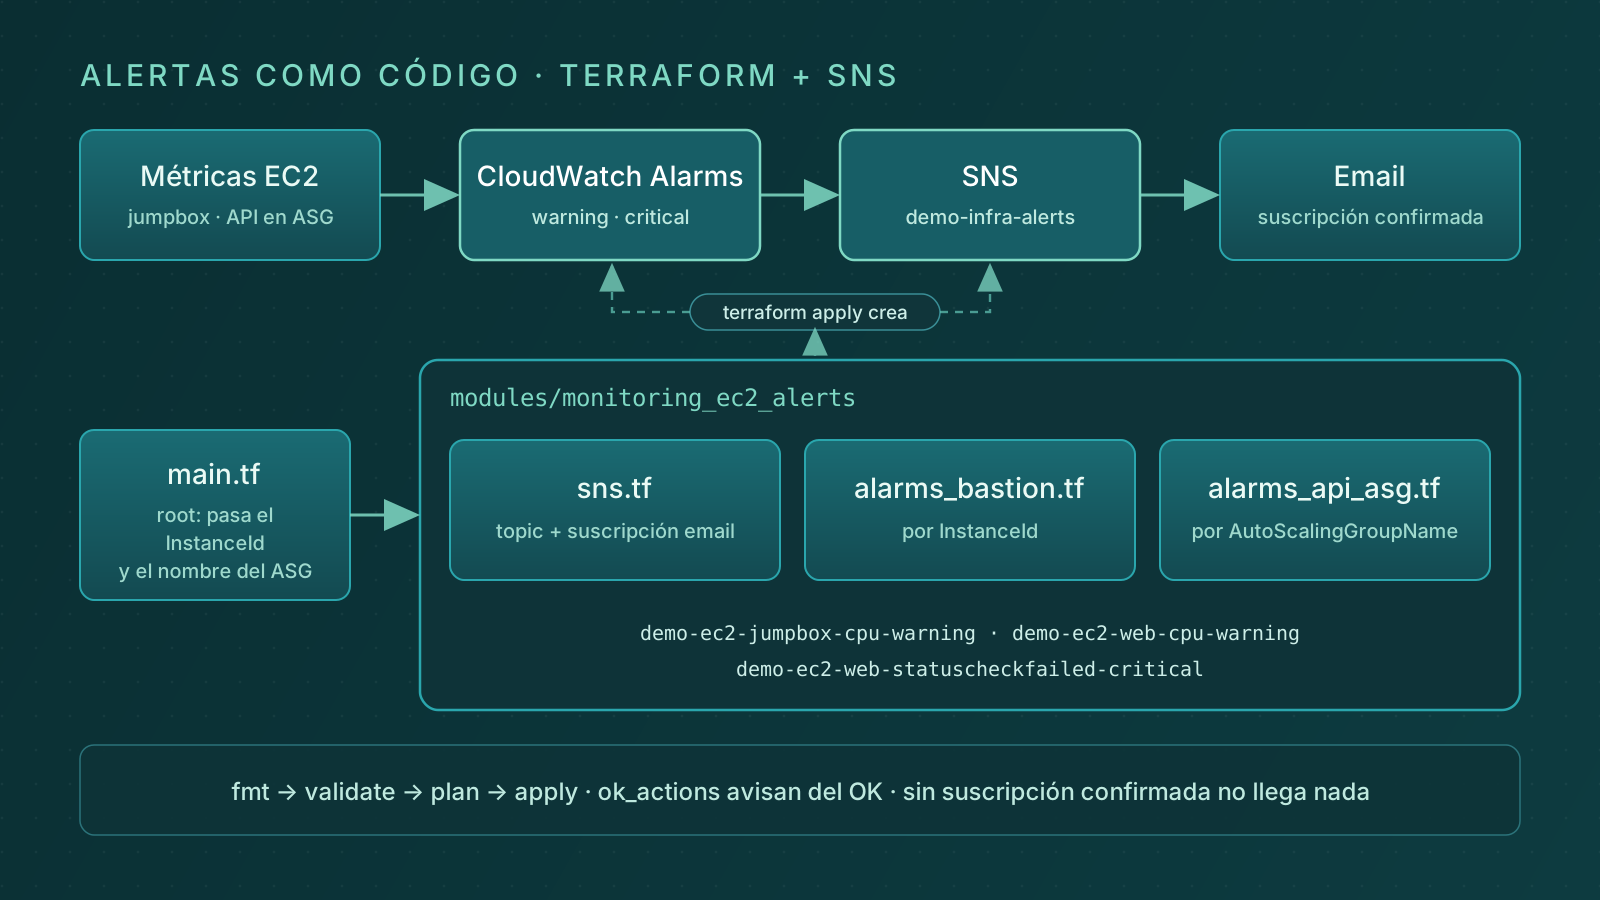
Con las alarmas en código, cada cambio pasa por un PR, se lee en el plan y se repite igual en todos los entornos. Este post recoge las decisiones; la implementación está en Alarmas de infraestructura con Terraform.
Las decisiones se toman una vez. El Terraform solo las repite en cada entorno.
Tres piezas, cada una con un trabajo
- Las métricas nativas de
AWS/EC2, que la instancia publica sin instalar nada. - Las alarmas de CloudWatch, que evalúan un umbral y cambian de estado.
- Un topic SNS, que reparte el aviso.
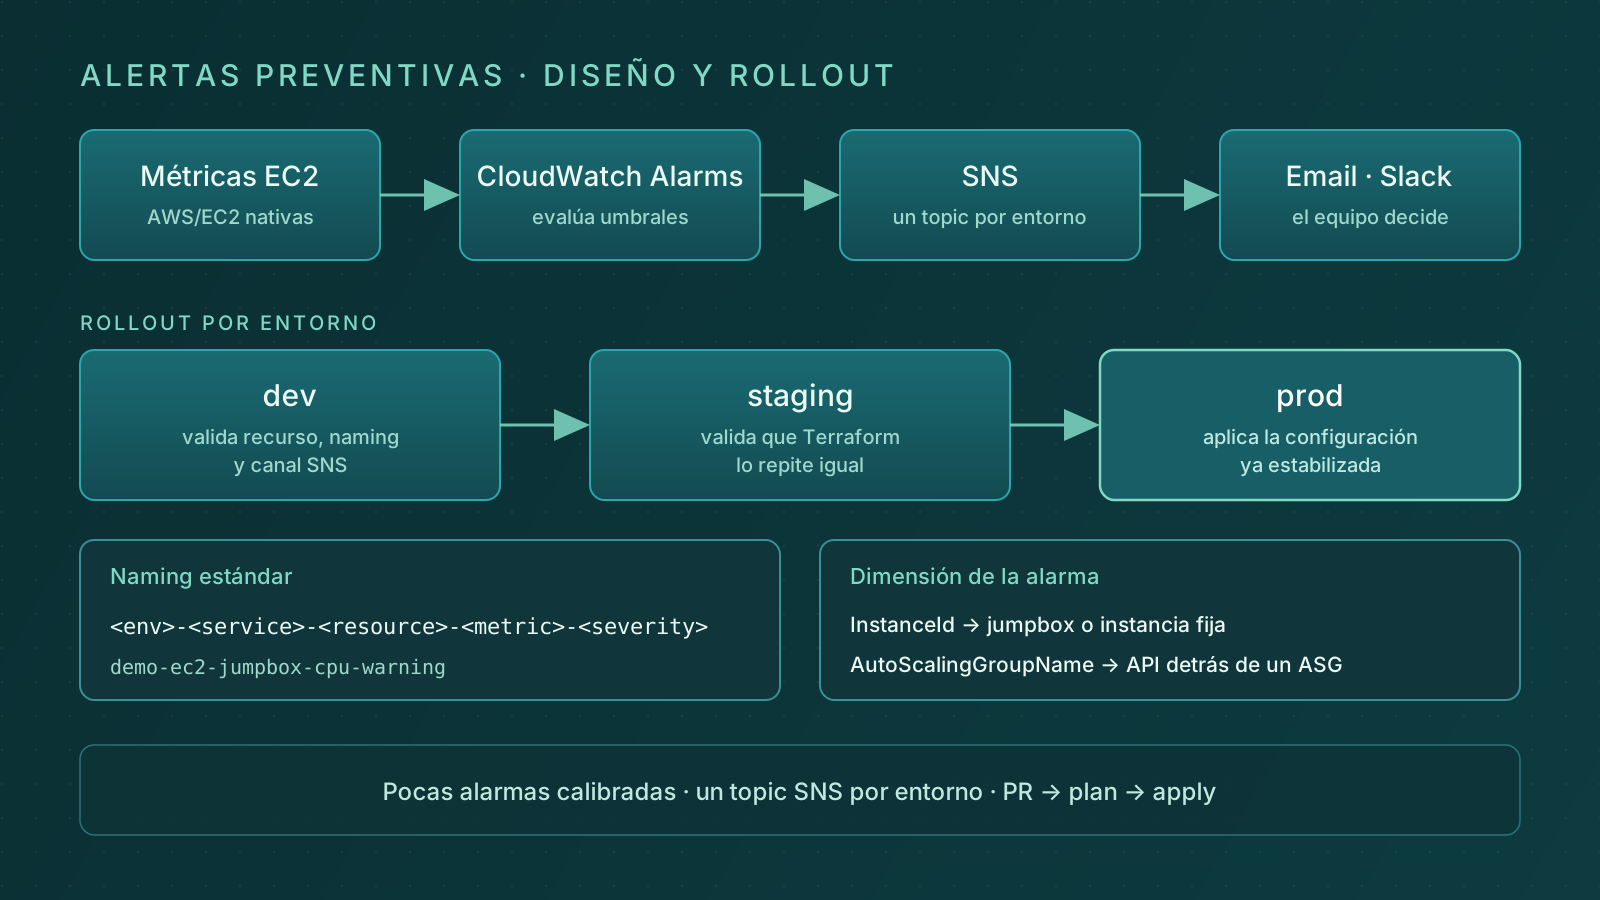
CloudWatch evalúa y SNS distribuye. Al separarlas puedo cambiar el canal (email hoy, Slack o Chatbot mañana) sin tocar ninguna alarma.
Qué alertar: pocas alarmas, bien calibradas
Prefiero cuatro alarmas que se atienden a veinte que se ignoran. Este fue el punto de partida:
| Alarma | Condición | Severidad |
|---|---|---|
CPUUtilization | media > 75 % durante 5 min | warning |
CPUUtilization | media > 85 % durante 10 min | critical |
StatusCheckFailed | > 0 en 1 min | critical |
CPUCreditBalance | saldo bajo, solo en instancias t* | warning |
Uso dos severidades y ninguna más. Warning significa «míralo hoy»; critical, «actúa ya». Si una alarma no encaja en ninguna de las dos, probablemente no hace falta.
La severidad la marca la ventana tanto como el umbral. Un pico de un minuto no es crítico; diez minutos sostenidos, sí.
Naming y etiquetas
Todas las alarmas siguen el mismo patrón, que es el que uso en el resto de la serie:
# patrón de nombre de alarma
<env>-<service>-<resource>-<metric>-<severity>

demo-ec2-jumpbox-cpu-warning
demo-ec2-jumpbox-cpu-critical
demo-ec2-web-cpucreditbalance-warning
demo-ec2-web-statuscheckfailed-critical
Con el nombre así, filtrar por entorno o por severidad en CloudWatch es buscar un prefijo o un sufijo. Además, cada alarma lleva las mismas cinco piezas como etiquetas: Environment, Service, Resource, Metric y Severity.
Un topic SNS por entorno
No mezclo avisos de dev, staging y prod en el mismo topic. Cada entorno tiene el suyo, con el patrón <env>-infra-alerts; en mi cuenta de laboratorio es demo-infra-alerts.
Así un aviso de dev no despierta a nadie, y al probar un entorno nuevo sé que lo que llega viene de ese entorno.
InstanceId o AutoScalingGroupName
Es la decisión que cambia la forma del código, así que la tomé antes de escribir la primera alarma.
InstanceIdpara instancias fijas, como un jumpbox. Es granular, pero si la instancia se reemplaza, la alarma se queda mirando un ID que ya no existe.AutoScalingGroupNamepara lo que vive detrás de un ASG, como el servidor web. Sobrevive a los reemplazos, pero agrega todas las instancias del grupo.
Con la dimensión del ASG, una instancia saturada puede quedar escondida en la media del grupo. Lo acepto para la capa web; para el jumpbox, no.
Dónde vive en Terraform
Las alarmas y el topic van en un módulo propio, modules/monitoring_ec2_alerts. El root solo le pasa lo que no puede saber: el ID de la instancia, el nombre del ASG y el email del aviso.
Así el root sigue siendo un orquestador y el módulo se reutiliza tal cual en cada entorno. El código completo está en Alarmas de infraestructura con Terraform.
Rollout: un entorno cada vez
Cada entorno valida una cosa distinta:
dev: que los recursos, el naming y el topic SNS son los esperados.staging: que el mismo módulo se repite sin tocar nada.prod: aplicar una configuración que ya no da sorpresas.
Dentro de cada entorno sigo también un orden. Primero el topic y su suscripción confirmada, después una sola alarma y una prueba controlada, y al final el resto.
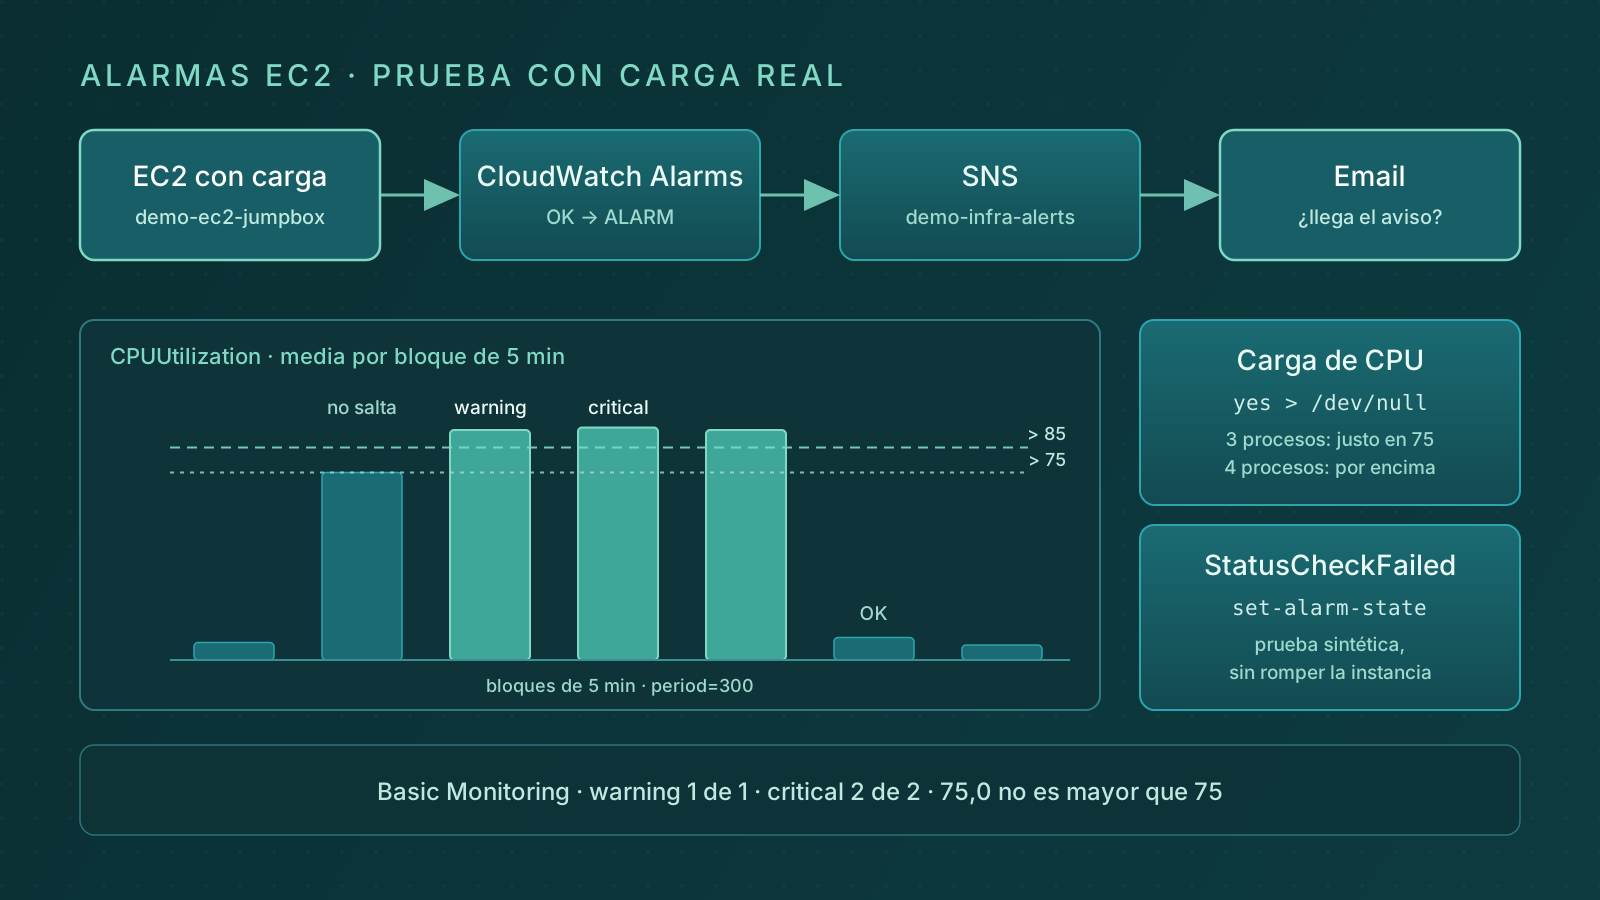
Cada paso entra por un PR: terraform validate, terraform plan y apply solo cuando el diff se entiende de un vistazo. La prueba con carga real la cuento en Alarmas de CloudWatch para EC2, probadas con carga real.
Una alarma desplegada no está validada hasta que su aviso ha llegado de verdad a alguien.
Antes de escribir Terraform
- Lista mínima de alarmas, con su severidad y su ventana.
- Patrón de naming y etiquetas cerrado.
- Un topic SNS por entorno.
InstanceIdoAutoScalingGroupName, decidido por recurso.- Orden de rollout y prueba real prevista en cada entorno.
Lo que aprendí
Decidir entre InstanceId y AutoScalingGroupName antes de la primera alarma me evitó rehacerlas. Y la diferencia entre warning y critical la puse en la ventana de tiempo, no solo en el umbral.
Si tienes dudas o lo estás montando tú, cuéntamelo.