El problema
Monté la plataforma de un servicio de IA cuyo código escribe el equipo de desarrollo. Desplegarlo y operarlo me enseñó qué separa un prototipo que llama a un LLM de un servicio que aguanta la caída del proveedor, cambia de motor sin cortes y un equipo puede depurar.
Montar el prototipo es cosa de una tarde. Lo difícil es que no se caiga cuando falla el proveedor, que escale sin ahogarse y que alguien entienda por qué respondió lo que respondió.
El objetivo del servicio no es «responder algo». Es interpretar la intención de cada consulta, repartir el trabajo entre agentes especializados, usar herramientas reales y devolver respuestas trazables. Está hecho en Python con FastAPI y corre en AWS. Aquí cuento su diseño y lo que vi al llevarlo a producción.
Lo difícil de un backend de IA en producción no está en el prompt. Está en la orquestación, la resiliencia, el despliegue y la observabilidad.
Orquestación multiagente
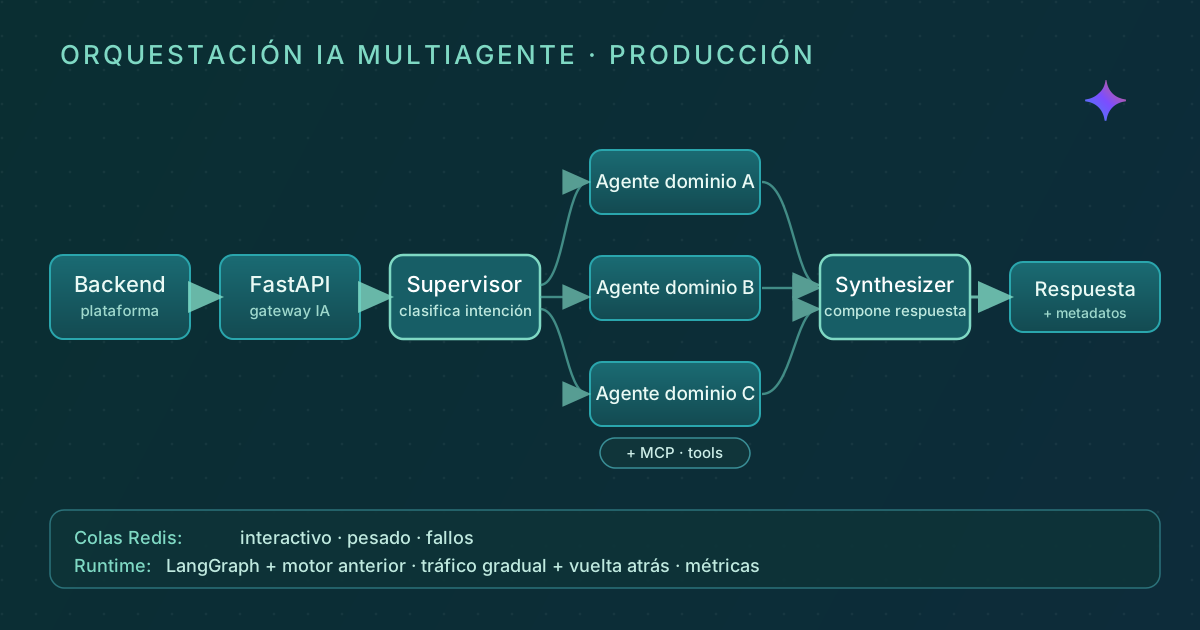
El servicio usa LangGraph y reparte cada consulta en tres pasos, en vez de pedírselo todo a una sola llamada:
- Supervisor: interpreta la intención y elige el agente adecuado.
- Agentes especializados: cada uno con su prompt de dominio y con herramientas externas vía MCP o function calling.
- Síntesis: compone la respuesta final cuando han intervenido varios agentes o herramientas.
Cada respuesta sale con metadatos de cómo se produjo: qué agente la atendió, qué herramientas usó, con qué proveedor y con qué versión de prompt.
Esos metadatos son la diferencia entre adivinar y depurar. Sin ellos, «el bot ha dicho algo raro» no lleva a ningún sitio. Con ellos, se sabe qué camino siguió esa consulta.
Cambiar el motor sin apagarlo
Cambiar el motor de un sistema en producción de golpe es pedir un incidente. Por eso el motor nuevo, basado en LangGraph, convive con el anterior. La configuración decide quién atiende cada petición, no un despliegue.
- Tráfico gradual: una parte de las peticiones va al motor nuevo y se sube poco a poco, sin redesplegar.
- Vuelta atrás automática: si el motor nuevo falla, la petición cae al de siempre y el usuario no lo nota.
- Proveedor de respaldo: si el proveedor de IA principal no responde, el servicio sigue en modo degradado.
Así, una migración que daba miedo se convirtió en una palanca. Se gira poco a poco y se revierte en segundos.
Dos motores conviviendo añaden estado. Si no registras cuál atendió cada petición, pierdes la pista al comparar resultados.
Colas por criticidad
Si todo va a una sola cola, un proceso largo o una herramienta lenta acaban degradando la conversación en tiempo real. Por eso las colas en Redis separan el trabajo por criticidad.
Lo interactivo y lo pesado van por caminos distintos. Lo que falla se guarda aparte para inspeccionarlo y reprocesarlo, sin bloquear al resto.
El servicio admite llamadas síncronas y asíncronas. Quien lo consume elige el modo según su caso de uso.
La cola de fallos se diseña el primer día. Añadirla después es descubrir qué se perdió mientras no existía.
Integración con contrato
La conexión con el resto de la plataforma es un contrato explícito: autenticación entre servicios con token y direcciones configurables.
La decisión que más disgustos ahorra es validar la configuración al arrancar. Si un token o una dirección no cuadran, el servicio lo dice al arrancar. No dos horas después, con un error opaco.
Despliegue y observabilidad
Esta es la parte que construí yo. El servicio se empaqueta con Docker y llega a AWS con un pipeline de CI/CD: validación, empaquetado y despliegue automatizado con CodeDeploy, sin SSH y con los secretos de cada entorno en un gestor de secretos. El enfoque general lo cuento en Pipeline CI/CD en AWS con rollback automático.
Un servicio de IA se vigila como cualquier otro servicio crítico. Expone salud, métricas y alertas: latencias, errores, estado de las colas y cuántas veces se ha tirado del respaldo.
El comportamiento de un agente vive en sus prompts, así que los prompts se versionan y se publican desde una API de administración. Cambiar cómo responde un agente no exige desplegar.
Si los prompts se cambian sin versión, una respuesta de ayer no se puede reproducir hoy. Por eso la versión viaja en los metadatos.
Antes de llevarlo a producción
- Cada respuesta dice qué agente, qué herramientas y qué versión de prompt intervinieron.
- Colas separadas por criticidad y fallos guardados aparte desde el primer día.
- Respaldo diseñado antes que la funcionalidad: el proveedor o el motor van a fallar.
- Configuración validada al arrancar.
- Registro de qué motor atendió cada petición mientras conviven los dos.
Lo que aprendí
Poner IA en producción es, sobre todo, un problema de ingeniería de plataforma. El modelo se puede cambiar; lo que sostiene el servicio es la trazabilidad, el respaldo y las colas que hay alrededor.
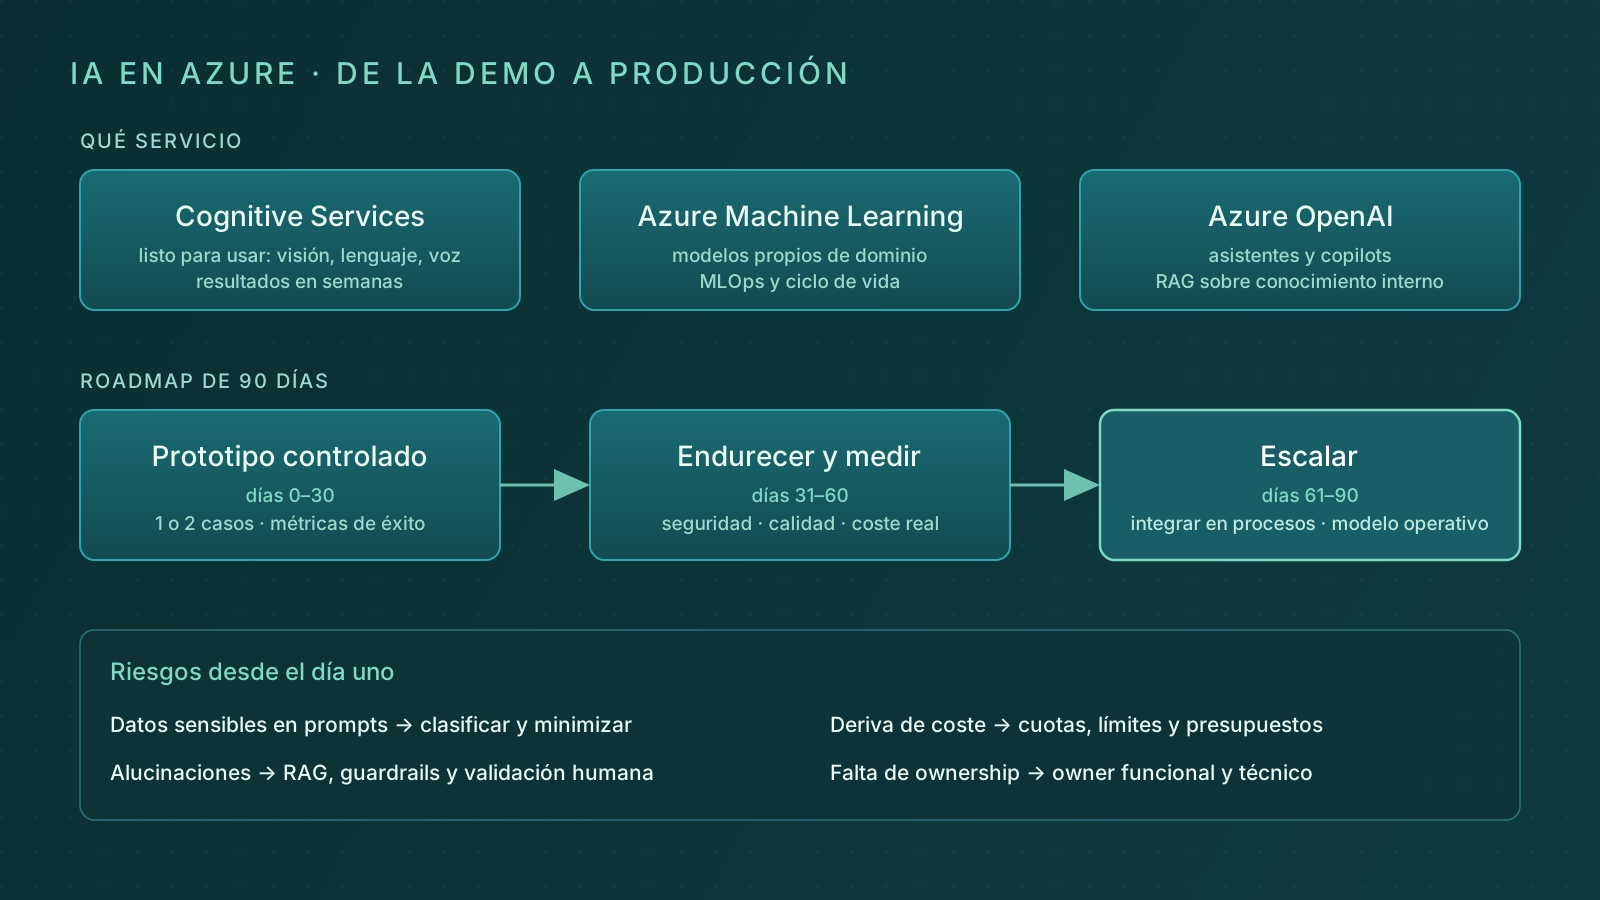
Relacionado: Plataforma para un servicio de IA (proyecto) · IA en Azure: cómo pasar de la demo a producción
Si tienes dudas o lo estás montando tú, cuéntamelo.