
El problema
Puse en producción un SaaS multi-tenant propio sobre Cloud Run. En reposo cuesta casi nada, la base de datos y la caché no se ven desde internet y publicar una versión es un comando.
El punto de partida era un monorepo con una API en NestJS y una web en Next.js que comparten dependencias. Además había trabajos en segundo plano: envíos de correo, recordatorios y publicaciones programadas. Y no tenía un equipo de plataforma detrás.
En serverless lo difícil no es que arranque: es que cada pieza tenga un solo trabajo y que el tráfico de datos no salga de la red privada.
Cada pieza en su servicio
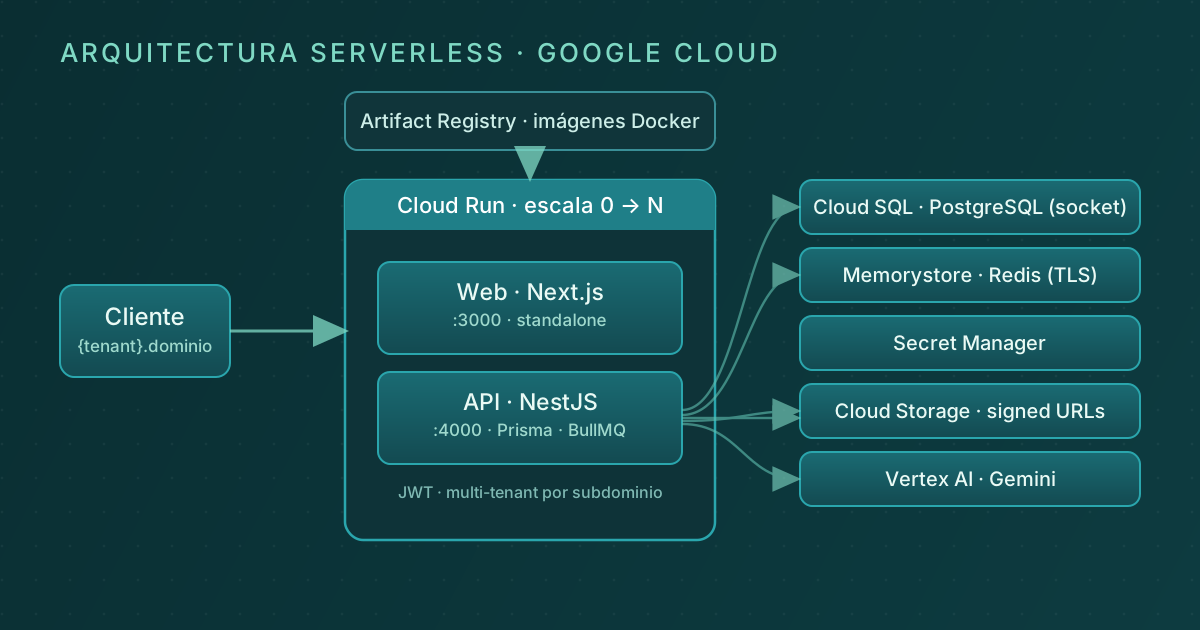
El diagrama de arriba resume el reparto. Cada responsabilidad cae en un servicio gestionado distinto:
- Cloud Run: dos servicios, la web y la API, que escalan de 0 a N según el tráfico.
- Cloud SQL (PostgreSQL), al que la API llega por un socket local.
- Memorystore (Redis) para la caché y las colas, solo accesible desde la VPC y con TLS.
- Cloud Storage para los ficheros, servidos con signed URLs temporales y no con el bucket abierto.
- Vertex AI (Gemini), autenticado con la service account del servicio, sin claves que guardar.
- Secret Manager para las cadenas de conexión, los secretos de JWT y las claves de terceros.
- Artifact Registry como repositorio Docker privado.
La landing es estática y va aparte, en Firebase Hosting, separada del panel.
Imágenes pequeñas, atadas a un commit
Las dos apps usan Dockerfiles multi-stage sobre node:22-slim. El build se lanza desde la raíz del monorepo y cada imagen se etiqueta con el SHA del commit, además de latest.
Así cualquier revisión de Cloud Run lleva a un commit concreto. La imagen de la API se quedó en unos 164 MB, y eso se nota en el arranque en frío.
La web usa el output standalone de Next.js. Genera un servidor autocontenido que solo lleva las dependencias que de verdad se usan.
Las variables NEXT_PUBLIC_* se hornean al construir la imagen. Cambiarlas en Cloud Run no sirve: hay que reconstruir.
Datos privados: socket y VPC
Lo que más pesa en la seguridad es cómo llega Cloud Run a la base de datos y a la caché.
Con --add-cloudsql-instances, Cloud Run monta el Cloud SQL Auth Proxy dentro del contenedor. La API se conecta a un socket Unix local, y el proxy abre un túnel autenticado hasta la instancia.
Redis solo tiene IP privada. Con Direct VPC egress en modo private-ranges-only, el contenedor la alcanza sin un connector serverless. El resto del tráfico sale por el camino normal.
La conexión a Redis va cifrada, con rediss://. El resultado es que ni la base de datos ni la caché aceptan conexiones desde internet.
El deploy, en un comando
Todo lo anterior cabe en una sola orden. Es la misma para la API y para la web; solo cambian el servicio, los secretos y la salida a la VPC.
# deploy de la API: imagen del commit, secretos, socket de Cloud SQL y salida a la VPC
gcloud run deploy mi-api \
  --image=europe-southwest1-docker.pkg.dev/mi-proyecto/mi-repo/api:$GIT_SHA \
  --region=europe-southwest1 \
  --min-instances=0 \
  --add-cloudsql-instances=mi-proyecto:europe-southwest1:mi-db \
  --network=default --subnet=default --vpc-egress=private-ranges-only \
  --set-secrets=DATABASE_URL=database-url:latest,REDIS_URL=redis-url:latest \
  --set-env-vars=NODE_ENV=production
--min-instances=0 es el escalado a cero. Sin tráfico no hay instancias encendidas y no se paga cómputo.
El precio es el arranque en frío: tras un rato sin uso, la primera petición tarda unos 2 o 3 segundos. Para un producto con tráfico irregular, me compensa.
Secretos fuera del código
Las variables sensibles viven en Secret Manager y entran con --set-secrets, como en el comando de arriba. La configuración que no es sensible va con --set-env-vars.
Rotar un valor es publicar una versión nueva del secreto y redesplegar. El código no cambia, porque la referencia apunta siempre a :latest.
Con :latest, cada instancia lee el secreto al arrancar. Si rotas sin redesplegar, conviven instancias con el valor viejo y con el nuevo.
Migraciones al arrancar
La API ejecuta prisma migrate deploy en el entrypoint, antes de levantar el servidor. Así una versión nueva nunca arranca con el esquema anterior.
Tiene una contrapartida: la migración corre en cada arranque en frío. Si una falla, el contenedor no levanta y el servicio se cae. Las migraciones delicadas las aplico aparte, a mano, antes de desplegar.
Colas dentro de la API
Los trabajos en segundo plano corren con colas dentro del propio proceso de la API, con Redis como backend. Mientras el volumen lo permita, me ahorro un servicio más.
Si hace falta escalar, el worker sale a su propio servicio de Cloud Run. El código de las colas no cambia: solo dónde se ejecuta.
Publicar una versión
- Build de la imagen multi-stage desde la raíz, etiquetada con el SHA del commit y con
latest. - Push de las dos etiquetas a Artifact Registry.
gcloud run deploycon los secretos, el socket de Cloud SQL y la salida a la VPC.- Migraciones aplicadas por el contenedor al arrancar.
- La landing, aparte, con Firebase Hosting.
Lo que aprendí
Escalar a cero también significa migrar en cada arranque en frío: una migración rota no rompe un deploy, rompe el servicio. Y las variables públicas de Next van dentro de la imagen, no en la configuración de Cloud Run.
Relacionado: SaaS multi-tenant en Cloud Run y GCP Cloud Run & Ops.
Si tienes dudas o lo estás montando tú, cuéntamelo.