datos · aws
ETL serverless con Terraform
Arquitectura ETL automatizada y reproducible en AWS, desplegada con Terraform.
- tipo
- laboratorio
- rol
- Infraestructura como código del pipeline ETL
- stack
- terraform · glue · athena
- resultado
- Un pipeline ETL que se crea, se destruye y se recrea en minutos, sin pasos manuales
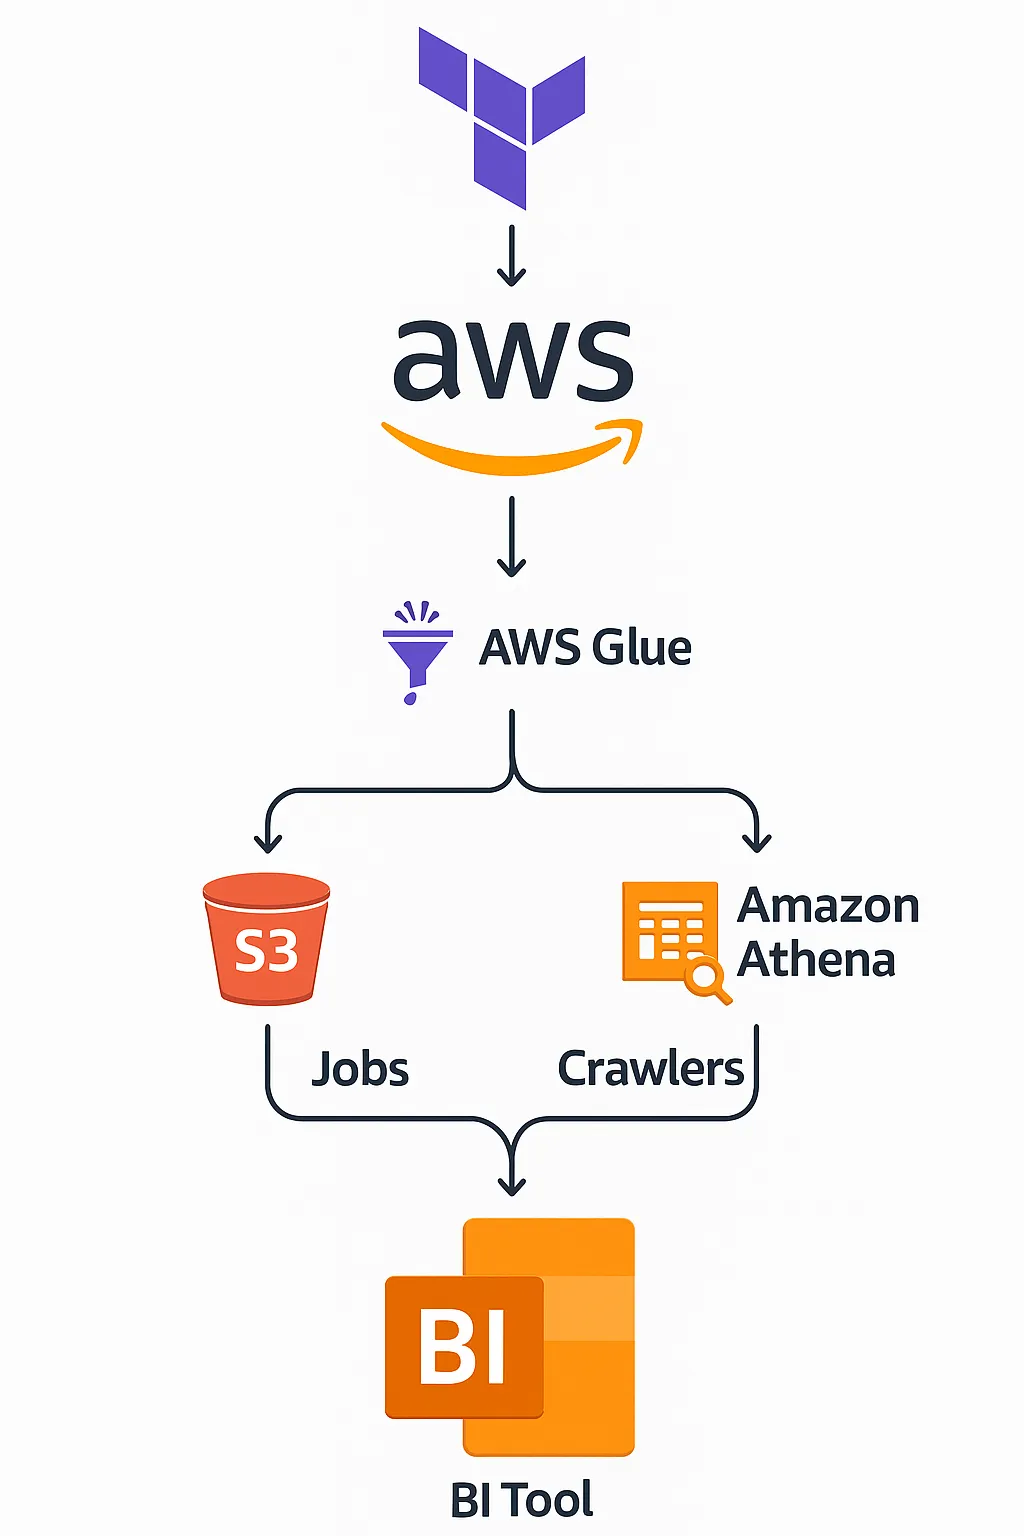
Llevé a Terraform un pipeline ETL serverless en AWS. Buckets, crawlers, bases de datos y vistas analíticas se crean en minutos y se pueden destruir y recrear sin pasos manuales.
El punto de partida
Un pipeline de datos montado a mano es difícil de repetir en otro entorno o en otra región. Cada paso manual es una ocasión de error y alarga el despliegue.
Qué hice
Definí todo el pipeline de forma declarativa, con módulos reutilizables por entorno. El objetivo era tener dev, staging y prod idénticos y poder crecer a más clientes o datasets sin rehacer nada.
Cómo lo hice
Almacenamiento
Terraform crea los buckets S3 con la estructura Bronze, Silver y Gold, con etiquetado multi-tenant.
Catálogo y jobs
Los Glue Crawlers, las bases de datos y los Glue Jobs salen del mismo código. Los jobs se parametrizan por cliente o por tipo de dataset.
Consulta
Terraform genera también las vistas y catálogos de Athena, así que los datos se pueden consultar en cuanto el entorno existe. Power BI o QuickSight se conectan sin pasos manuales.
Resultado
El entorno completo se destruye y se recrea en minutos, igual en cualquier región.
Al ser infraestructura inmutable, dev, staging y prod parten del mismo código. Eso reduce los errores humanos y el tiempo de despliegue.
Qué me llevo
Poder destruir un entorno sin miedo es la mejor prueba de que el código lo describe entero. Lo que solo existe porque alguien lo creó a mano se pierde al recrearlo.
Arquitectura
Módulo de entorno → buckets S3 (Bronze, Silver, Gold) → Glue Crawlers y Jobs → catálogo y vistas de Athena → herramienta de BI.