datos · aws
Recuperación de backups MySQL sin restaurar
Consultar datos históricos directamente desde los .sql.gz, sin levantar una base de datos.
- tipo
- laboratorio
- rol
- Diseño, desarrollo y despliegue del pipeline
- stack
- step functions · lambda · fargate · glue · athena · terraform
- resultado
- Un backup .sql.gz real convertido en Parquet y consultable desde Athena, sin restaurar la base
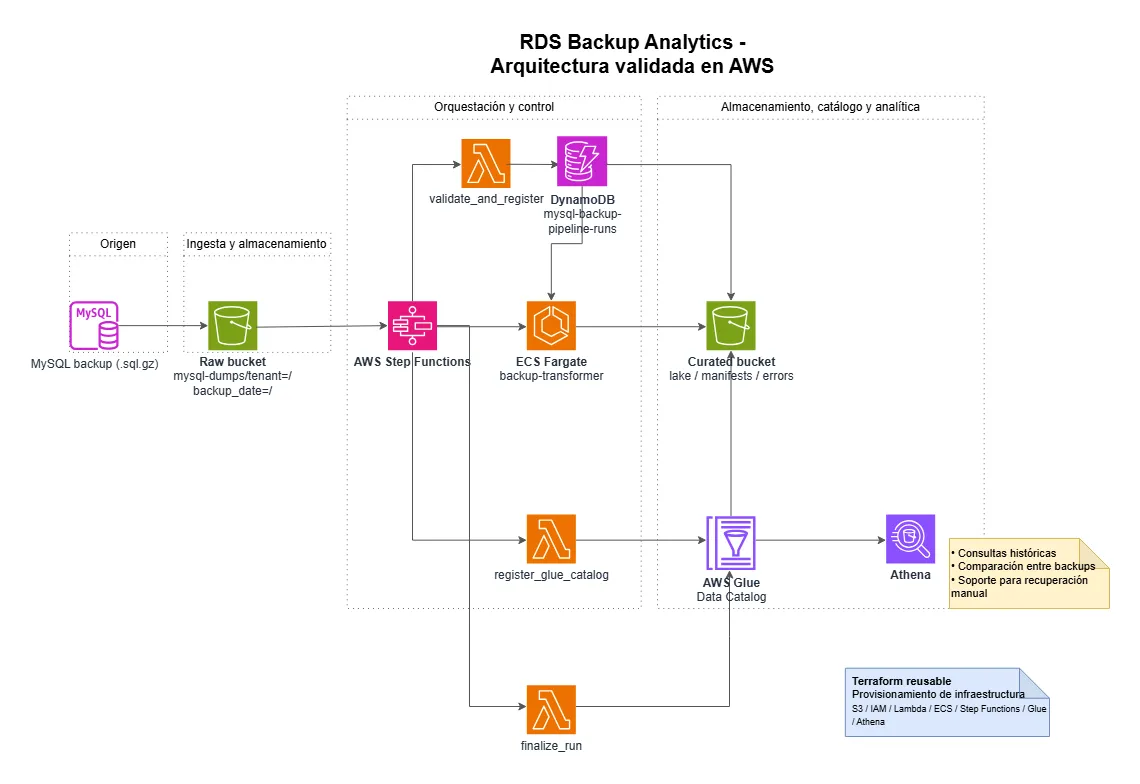
Convertí un proceso manual de recuperar datos históricos en un pipeline reproducible en AWS. Un backup MySQL .sql.gz acaba en Parquet y se consulta desde Athena, sin restaurar ninguna base de datos.
El punto de partida
Revisar un backup antiguo era casi siempre manual. Había que localizar el dump, descargarlo, restaurarlo en local o en una instancia temporal y buscar los registros a mano.
Si hacía falta otra fecha u otro tenant, se empezaba de nuevo. Costaba tiempo, dependía del entorno de un developer y apenas dejaba rastro de qué se había procesado.
Qué hice
Diseñé un flujo que conserva el dump original y lo transforma bajo demanda en una capa analítica. El objetivo era muy concreto: consultar histórico desde backups sin restaurar bases completas. No pretendía cubrir todos los escenarios de restauración.
Cómo lo hice
Fuente intacta
El dump original se guarda sin tocar en S3 raw. Es la fuente de verdad: cualquier transformación se puede repetir desde ahí.
Orquestación
Step Functions dirige la ejecución. Lambda se encarga de validar la entrada, generar un run_id para seguir cada procesamiento y catalogar al final.
Transformación
Fargate descomprime el fichero, parsea el SQL y escribe las tablas en Parquet. Elegí Fargate porque el parseo y la escritura se salen de lo cómodo para una sola Lambda. Parquet reduce lo que escanea Athena en cada consulta.
Catálogo y código
Registré tablas y particiones en Glue de forma explícita, para controlarlas mejor y mantener la trazabilidad. Después repliqué en Terraform el flujo ya validado, para dejarlo reutilizable.
Resultado
El pipeline funcionó en una cuenta AWS real con un backup MySQL comprimido real.
- Se generaron datasets Parquet en la capa curated.
- Se escribió un
manifest.jsoncomo evidencia de cada ejecución. - Glue creó las tablas y las particiones.
- Athena devolvió resultados válidos, filtrando por
tenantybackup_date.
El MVP tiene límites claros. El parser solo entiende CREATE TABLE e INSERT INTO ... VALUES, y algunos tipos se degradan a string en el catálogo. El SQL exótico y los BLOBs piden más trabajo, y la reinserción en el MySQL de origen queda fuera.
Qué me llevo
Validar el flujo primero en AWS y llevarlo a Terraform después me evitó codificar decisiones aún sin probar. Acotar el problema a «consultar, no restaurar» fue lo que lo hizo abarcable.
Arquitectura
- El backup
.sql.gzentra en S3raw. - Step Functions valida la entrada y genera el
run_id. - Fargate descomprime, parsea y escribe Parquet en
curated. - Glue registra tablas y particiones.
- Athena consulta por
tenantybackup_date.